分类问题中的算法
2020-12-21李晓明
中国信息技术教育 2020年23期
关键词:分类
李晓明
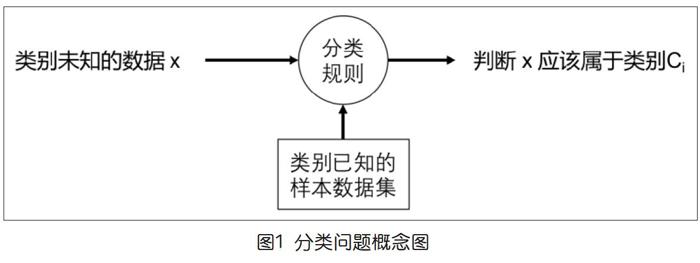
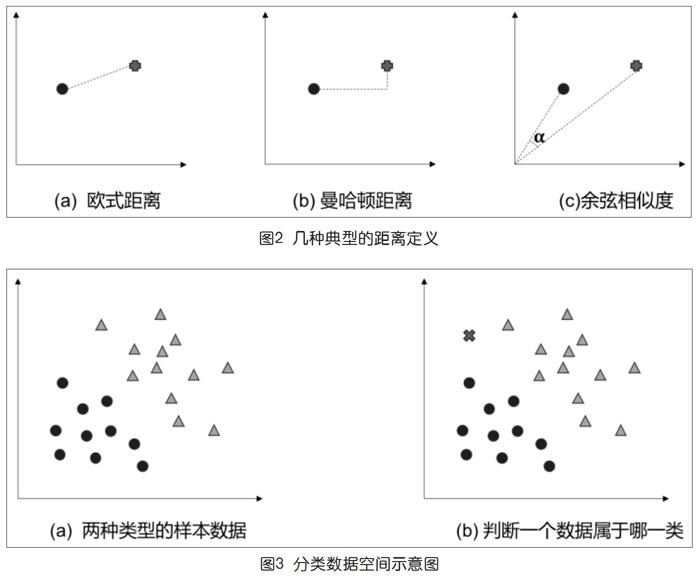
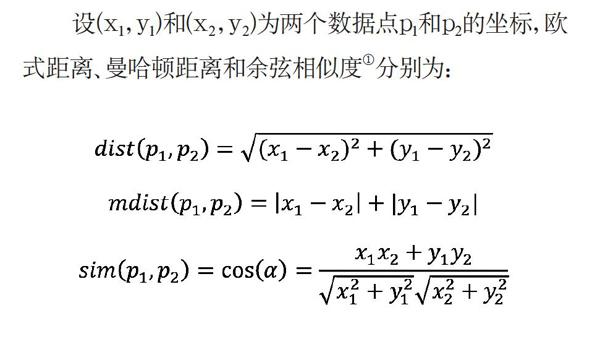
现在,人工智能很热。人工智能应用中有些很基本的需求,分类即为其中最常见的一种。分类关心的是如何将一个对象归到已知类别中。例如,人可以分为少年、青年、中年、老年四个类别,商品可以分为廉价和高档两个类别,学生在课堂上的表现可分为积极踊跃、沉稳细致、不以为然三个类别,网购者可分为随性和理性两种类别,等等。在日常生活中,这种分类主要凭感觉。而如果用计算机来做,则每一种类别都需要通过一些数据特征予以刻画,每一个对象或者说个体都是通过一个“数据点”来表示,如后面要讲的一个网购的例子,其数据特征就用了“每月网购次数”和“每次平均花费”。一个每月网购10次、每次平均花费120元的人则用数据点(10,120)来表示。
不难体会到,把一个个体归到预设的类别中,有些比较容易,有些则很不容易。鉴于分类在现实中有广泛的应用,人们发明了多种算法,应对各种不同的情形。本文介绍两个最基本的算法——K近邻(KNN)算法和支持向量机(SVM)算法。
这两个算法的基本思路都很简单直观。KNN的实现容易理解,因而人工智能的教材里一般都会有它。SVM的常规实现需要较深的数学基础,因而一般初等人工智能教材都没有它。不过,由于SVM实在很重要,最近也看到有尝试在中学人工智能教材中介绍它[1],只是在介绍了算法基本思想后用了一句“这个问题可以用优化方法求解,但具体过程已经超出了同学们现阶段的知识储备,等到同学们以后学习了相关的数学工具后,就可以求解了”就结束了。……
登录APP查看全文
