端到端语音识别研究综述
2020-12-21郭宗昱刘博吴可欣李姝怡蒋昊轩李云洁
郭宗昱 刘博 吴可欣 李姝怡 蒋昊轩 李云洁
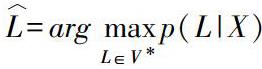
摘 要:语音识别(ASR)是机器学习领域的热点研究问题。长期以来,隐马尔可夫模型-高斯混合模型(HMM-GMM)是传统语音识别主要框架,随着深度学习的快速发展,DNN模块取代GMM,语音识别性能有了一定程度的提升。然而,HMM-DNN模型本身受到各种不利因素的限制,而端到端模型(End-To-End ASR)具有流程简化等优点。因此,端到端模型是语音识别未来的重要研究方向。本文首先介绍传统语音识别的基础理论;然后介绍了HMM-GMM模型和HMM-DNN模型构架;其次,重点介绍了两种不同类型的端到端模型的基本原理;通过以上对比研究,最后总结了语音识别存在的问题和未来发展方向。
关键词:语音识别;端到端;深度学习;CTC;注意力机制
1 绪论
因此,ASR的基本工作是建立一个可以准確计算后验分布p(L|X)的模型。
与基于HMM的模型相比,端到端模型使用单个模型将音频直接映射到字符或单词,更易于构建和训练等优点使其迅速成为大型词汇连续语音识别研究的热点。
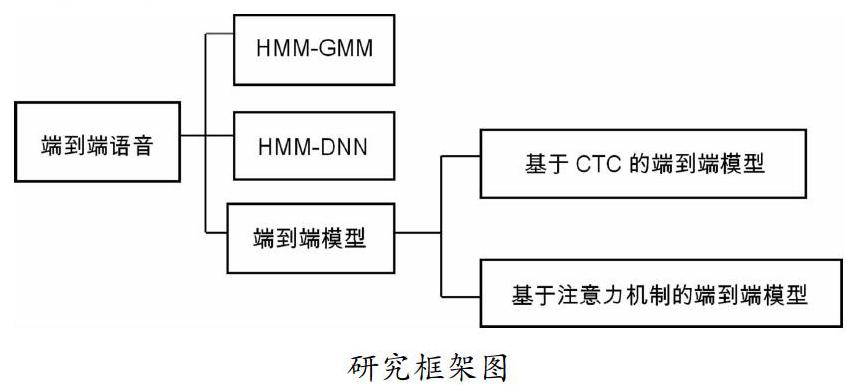
本文的整体框架如下图所示:分别介绍传统语音识别模型(HMM-GMM)、基于传统模型改进的语音识别模型(HMM-DNN)、基于神经网络的端对端语音识别模型;端到端模型又分别介绍了基于CTC和注意力机制的模型。
2 基于HMM-GMM的语音识别模型
基于HMM的模型可以分为彼此独立并发挥不同作用的三个部分:声学模型、发音模型和语言模型。声学模型P(X|S),从隐藏序列S观察X的概率,用于对语音输入和功能序列之间的映射进行建模。发音模型P(S|L),也称为字典,是为了实现音素(或子音素)到音素之间的映射,建立声音序列和语言序列之间的联系。……