分布式深度学习研究
2017-10-16辜阳杨大为
科技创新与应用 2017年29期
关键词:深度学习
辜阳++杨大为
摘 要:传统单机深度学习模型的训练耗时,动辄花费一周甚至数月的时间,让研究者望而却步,因此深度学习并行训练的方法被提出,用来加速深度学习算法的学习过程。文章首先分析了为什么要实现分布式训练,然后分别介绍了基于模型并行和数据并行两种主要的分布式深度学习框架,最后对两种不同的分布式深度学习框架的优缺点进行比较,得出结论。
关键词:深度学习;分布式训练;模型并行;数据并行
中图分类号:TP181 文献标志码:A 文章编号:2095-2945(2017)29-0007-02
1 概述
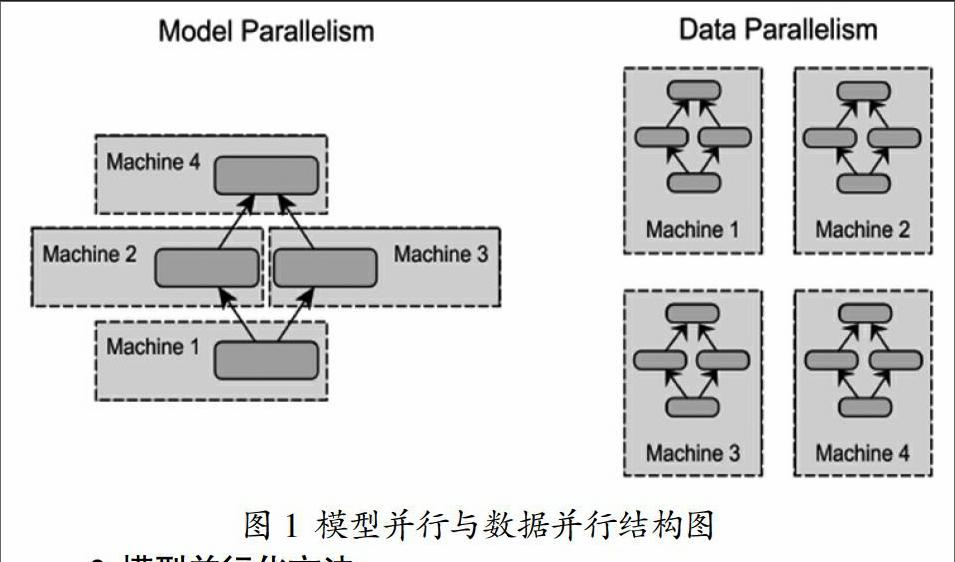
深度学习已经在计算机视觉,文本处理,自然语言识别等领域取得了卓越成就,受到学术界和工业界的广泛关注。随着对深度学习领域研究的深入,有证据表明增大模型参数规模和训练数据集,能有效的提高模型精度。但精度提升同时也带来了巨大的训练时间成本。简单的采用单机加GPU计算的方式,受限于目前GPU的显存限制和单机扩展能力,已经不能满足大型深层网络结构和超TB大小的训练集所要求的计算能力和存储空间。针对上述问题,研究者投入了大量的工作,研究分布式深度学习训练框架,来提升训练效率。当前的分布式深度学习框架主要包含模型并行(model parallelism),数据并行(data parallelism)两种方法,两者的结构如图1所示,左边为模型并行结构,右边为数据并行结构。
2 模型并行化方法
在模型并行化方法里,分布式系统中的不同机器节点负责单个网络模型的不同部分计算。例如,卷积神经网络模型中的不同网络层被分配到不同的机器。……
登录APP查看全文