一种改进型关联规则算法设计与研究
2021-11-03邓晓慧
邓 毅,邓晓慧
(1.重庆科创职业学院 人工智能学院,重庆 永川 402160 2.重庆城市职业学院 商学院,重庆 永川 402160)
1 Apriori算法概述
AIS算法是较早被用来解决关联规则问题的算法,但此算法在使用的过程中性能较低,于是Agrawal等人在此前的应用基础上,对AIS算法进行了相关的改造,Apriori算法此时便被提出来了,且成为利用关联规则进行数据挖掘较好算法之一[1]。依据Apriori算法,延伸出了类似Apriori-Hybrid、DIC、AprioriTid、DHP等算法。
1.1 Apriori算法过程
在Apriori算法运行之前,用户需要首先设定好最小支持度,一旦开始扫描事务数据库时,就仅计算每一个项目的具体值的数量,来确定大型1--项集,后面的n次遍历,都将重复连接与剪枝的操作,直到产生的项为空,停止算法。该算法的流程图如图1所示[2]。
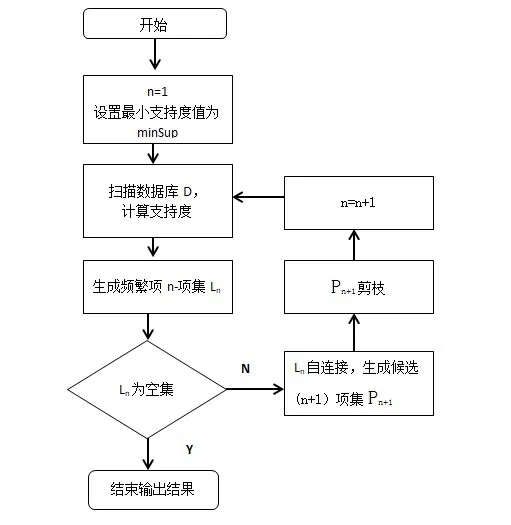
图1 算法执行过程
该算法通过逐层的迭代来得到需要的频繁项集,获取频繁项集的算法伪代码如下所示:
算法:Apriori算法生成频繁项集
输入:事务库D;最小支持度阀值minSup
输出:D中的频繁项集L
方法:
L1={发现频繁1-项集};
For(n=2;Ln-1≠φ;n++)
{
Cn=apriori_produce(Ln-1,minSup);
for each transactionT∈D{
CT=sub set(Cn,T);
for all candidate c∈CT
C.count++;
}
Ln={c∈Cn|c.count≥min Sup}
}
Return L={UnLn}
在该算法的伪代码方法中,Ln-1和min S up这两个值作为函数apriori_produce的参数值被代入,获取了候选n-项集Cn,这个函数进行了两个操作:连接操作、剪枝操作,如下所示的实现步骤[3]:
Function apriori_gen(Ln-1,minsup)
For each itemset S1∈Ln-1
For each itemset S2∈Ln-1

c=s1⊲s2;
If exist_infrenquent_subset(c,Ln-1)
{
Delete c;
}
Else fill cnwith c;
}
Return cn
在完成了上述的n--项集后,使用Apriori的性质,需要对Cn进行剪枝的操作,删除掉拥有非频繁子集的候选。用于对非频繁子集测试的函数实现如下:
Function exist_infrenquent_subset(c,Ln-1)
for each(n-1)-subset p of c
If p∉Ln-1
Return true;
Return false;
1.2 Apriori算法实例解析
由于伪代码语言并不能够清晰的说明Apriori算法的执行过程,接下来将通过一个使用该算法产生关联规则的例子来说明。如表1所示的交易数据库Q。……