基于不完整乳腺癌数据的模型预测研究
2021-10-16邓钰芳
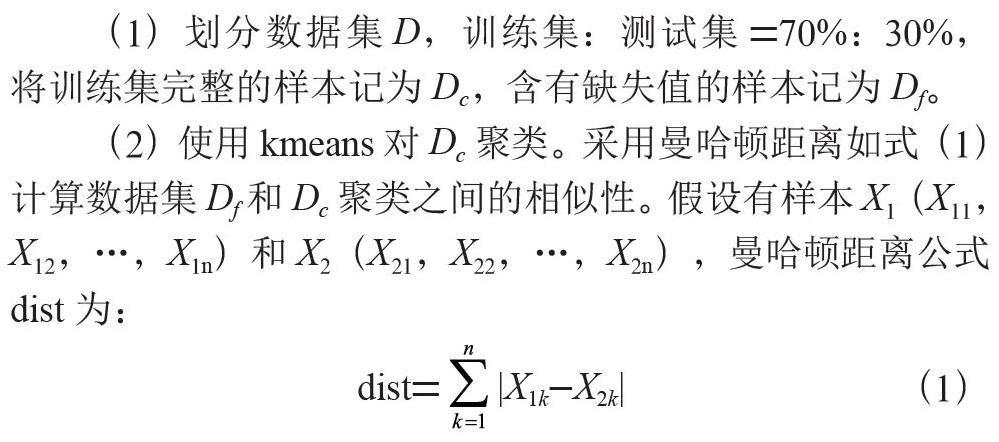
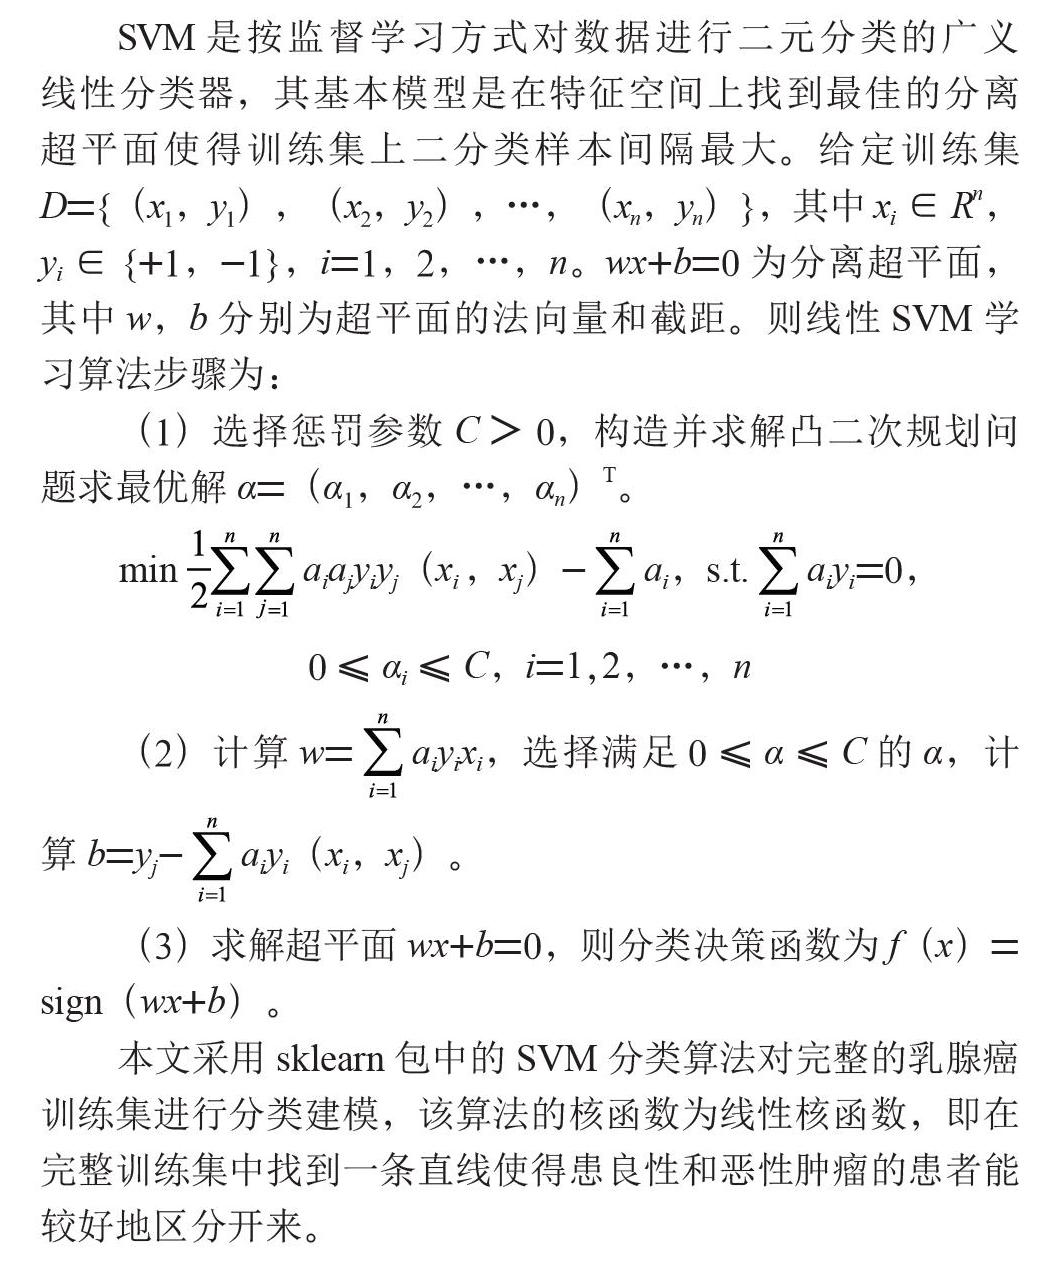
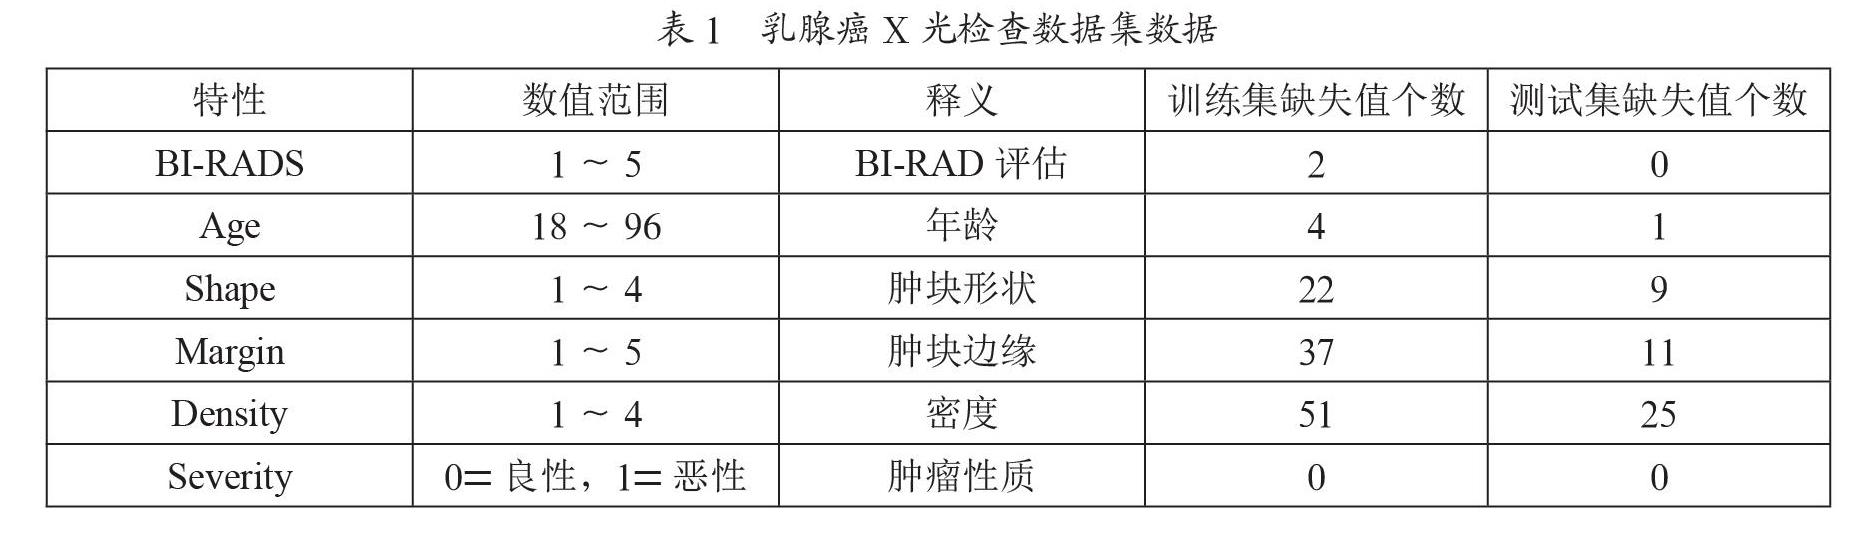
摘要:针对不完整乳腺癌数据问题,该研究提出kmeans-KNN方法处理缺失值。首先对训练集进行聚类并采用KNN进行缺失值填充,基于完整训练集训练线性回归模型填充测试集的缺失值,然后使用机器学习算法XGBoost、RF、KNN、SVM对完整训练集进行训练建模,利用建立好的模型对完整测试集进行测试。结果证明kmeans-KNN在缺失值预处理上优于EM、MICE等常用的缺失值填补方法,在准确度和AUC上,kmeans-KNN+SVM取得最优。
关键词:不完整数据;乳腺癌;诊断预测
中图分类号:R737.9 文献标识码:A 文章编号:2096-4706(2021)07-0050-04
Model Prediction Research Based on Incomplete Breast Cancer Data
DENG Yufang
(School of Computer,Electronics and Information,Guangxi University,Nanning 530004,China)
Abstract:Aiming at the problem of incomplete breast cancer data,the study proposed the kmeans-KNN method to deal with missing values. First,cluster the training set and use KNN to fill in missing values,and train a linear regression model based on the complete training set to fill in missing values in the test set. Then,machine learning algorithms XGBoost,RF,KNN,and SVM are used to train and model the complete training set and complete test is used to test. The results show that kmeans-KNN is better than EM,MICE and other common missing value filling methods in missing value preprocessing,and kmeans-KNN+SVM is the best in accuracy and AUC.
Keywords:incomplete data;breast cancer;diagnosis prediction
收稿日期:2021-03-09
0 引 言
据国际癌症研究机构(IARC)发布的最新数据显示[1],截至2020年乳腺癌已成为全球女性发病率最高的癌症。在大数据时代,使用机器学习方法建立乳腺癌诊断模型进行诊断预测为医生的临床决策提供科学参考是非常有意义的。然而机器学习方法的应用是基于完整可分类的数据。如果不对缺失数据进行处理则很难通过机器学习方法建立有效的生存预测模型,缺失数据的存在给乳腺癌生存预测带来了很大的难度,甚至有可能会使整个数据失去价值。因此针对缺失数据进行合理处理是非常有必要的。
针对不完整数据的处理,国内外已有大量的相关研究。如Hadi等人采用不处理、均值、EM和K-近邻(KNN)四种缺失值处理方法进行比较研究,并使用KNN、决策树、逻辑回归和支持向量机(SVM)四种机器学习算法构建乳腺癌生存模型,结果显示KNN+KNN建立的模型最佳,而均值填充法的效果远差于EM和KNN填充法[2]。但是大多数研究是先删除缺失数据然后基于随机缺失假定来采用缺失值填充法进行缺失值处理,并用均方根误差和错误率评价填充效果[3,4]。……
