使用K近邻算法诊断乳腺癌
2020-10-21赵宇
大东方 2020年3期
赵宇

摘 要:随着信息技术的不断发展,医疗大数据的概念也逐渐被人类所熟知。通过对数据挖掘技术在乳腺癌各领域的研究现状(乳腺癌基因研究、乳腺癌早期辅助检查、力学药物靶点识别、乳腺癌新中医治疗方法)的分析,展望数据挖掘技术应用于乳腺癌领域的前景,为数据挖掘技术在乳腺癌疾病的研究提供新思路。
关键词:数据挖掘;乳腺癌
一、前言
乳腺癌已成为当前社会的重大公共卫生问题。全球乳腺癌发病率自20世纪70年代末开始一直呈上升趋势。美国8名妇女一生中就会有1人患乳腺癌。中国不是乳腺癌的高发国家,但不宜乐观,近年我国乳腺癌发病率的增长速度却高出高发国家1~2个百分点。
二、数据源
我们将使用来自UCI的乳腺癌诊断数据集,该乳腺癌数据包括569例乳腺细胞活检样本,每个样本包含32个变量。其中id变量是样本识别ID,diagnosis变量是目标变量(M代表恶性,B代表良性)。其他30个变量都是由10个数字化细胞核的10个不同特征的均值、标准差和最大值构成。这10个基本特征为:
三、数据探索和预处理
.3.1 数据的探索
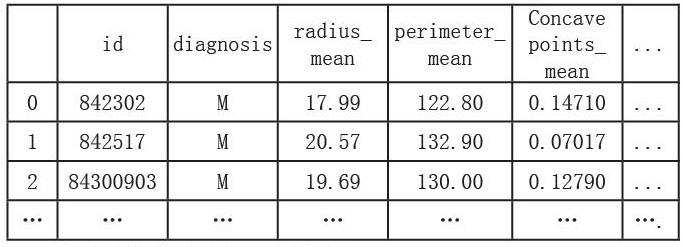
首先,搜集数据集如下图所示,由于数量问题,只显示其中部分,共计569个样本,32个变量。
将整个数据集导入SPSS软件中。
第一个变量为ID,无法为实际的模型构建提供有用的信息,所以需要将其删除。diagnosis变量是我们的目标变量,我们首先统计一下其取值分布。观察在我们的数据集中,恶性(M)和良性样本(B)的分布情况。在正式建模之前需要将其进行整数编码,将良性(B)编码为0,将恶性(M)编码为1。……
登录APP查看全文