基于MongoDB的文本分类研究
2017-06-21陈德森杨祖元
无线互联科技 2017年5期
陈德森 杨祖元
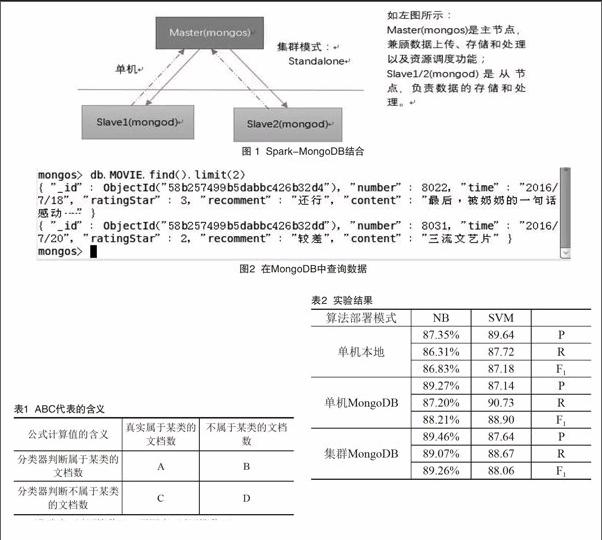
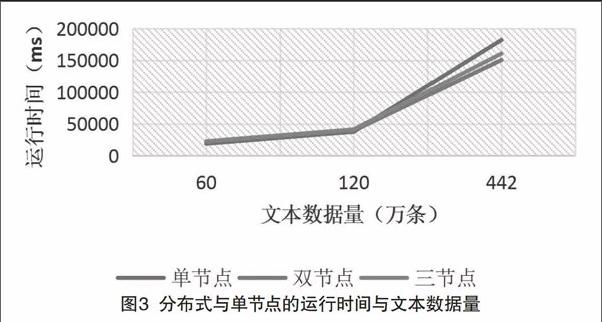
摘要:文章基于流行的非关系型数据库MongoDB,结合spark机器学习库中的朴素贝叶斯分类器和支持向量机,对豆瓣影评及京东商评进行情感分类,并采用准确率、召回率、F-Measure等指标对分类效果进行评价,最后测试了spark-MongoDB平台的扩展性能。
关键词:文本分类;Spark;MongoDB;MLlib
互联网发展促进了社交媒体、在线交易等新兴媒介的发展,这些网站每天都会产生数以亿计的数据。其中文本数据占据了重要位置,有80%的数据以文本形式存在的。如何有效利用这些文本数据去创造价值,是亟待解决的问题。
文本挖掘(Text Mining,TM)是指从非结构化文本中获取用户有用信息的过程。文本挖掘是从数据挖掘发展而来,但与传统的数据挖掘相比,文本挖掘有其独特之处,主要表现在:文档本身是半结构化或非结构化的,无确定形式并且缺乏机器可理解的语义;而一般数据挖掘的对象以数据库中的结构化数据为主,并利用关系表等存储结构来发现知识。
针对上述问题,本文将结合MongoDB和Spark,在文本存储及文本分类效果两方面进行研究。
1.文本数据的存储
上文所述产生的数据,通常是由关系数据库管理系统来处理。实践证明,关系模型是非常适合于客户服务器编程,它是今天结构化数据存储在网络和商务应用的主导技术。然而在数据爆炸的互联网时代,传统的关系型数据在应对大规模和高并发访问时显得力不从心,因此一批NoSQL数据库开始涌现,如MongoDB,Redis,Cassandra,HBase,CouchDB等。这些非关系型数据库旨在解决大规模集合以及多重数据类型带来的挑战,尤其适合大数据处理。……
登录APP查看全文