基于交通路网状态感知的交通信号配时优化技术
2021-11-28胡小光胡晓杰
胡小光 胡晓杰

摘 要:本文提出多通道的3D卷积预测网络结合Double-DQN的配时控制策略,并将其与Deep-Q-learning、Q-learning进行对比分析,进行仿真实验。结果表明,多通道的3D卷积预测网络结合Double-DQN的控制策略明显优于Q-learning和Deep-Q-learning。
关键词:智能交通信号配时;3D卷积;深度强化学习;多通道矩阵;Double-DQN
中图分类号:U491.54文献标识码:A文章编号:1003-5168(2021)16-0018-04
Abstract: In this paper, a multi-channel 3D convolution prediction network combined with Double-DQN timing control strategy was proposed, which was compared with Deep-Q-Learning and Q-Learning. The results show that the control strategy of multi-channel 3D convolution prediction network combined with Double-DQN timing control strategy is obviously better than Q-learning and Deep-Q-learning.
Keywords: traffic signal timing control;3D convolution neural network;deep reinforcement learning;multilevel network;Double-DQN
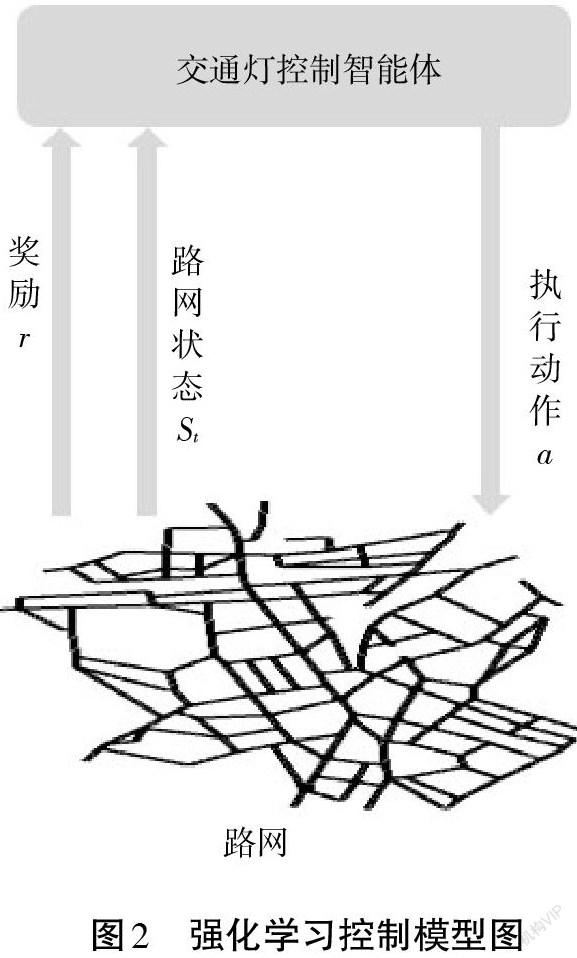
智能交通信號配时是一种缓解交通拥堵的有效手段。智能交通系统(Intelligent Transportation System,ITS)产生于20世纪60年代末70年代初。由于交通状况是随机的,可变性以及不确定性强,因此,很难训练出适合的模型对交通信号进行控制。强化学习的常见模型是标准的马尔可夫决策过程(Markov Decision Process,MDP)。强化学习是一类重要的机器学习技术,它通过与环境的交互来学习最优的控制决策[1]。交通信号控制领域很早就开始运用强化学习方法来解决交通控制问题。随着深度学习和强化学习的发展,它们被结合为深度强化学习用来估计[Q]值以代替复杂的[Q]值表。DeepMind团队将最新的AlphaGo论文发布在Nature上,使得深度强化学习算法受到多数研究人员的关注[2]。随着交通路网的扩大,道路信息变得复杂,对智能信号控制模型进行优化是探索智能交通的必经之路。
1 控制模型
1.1 相位
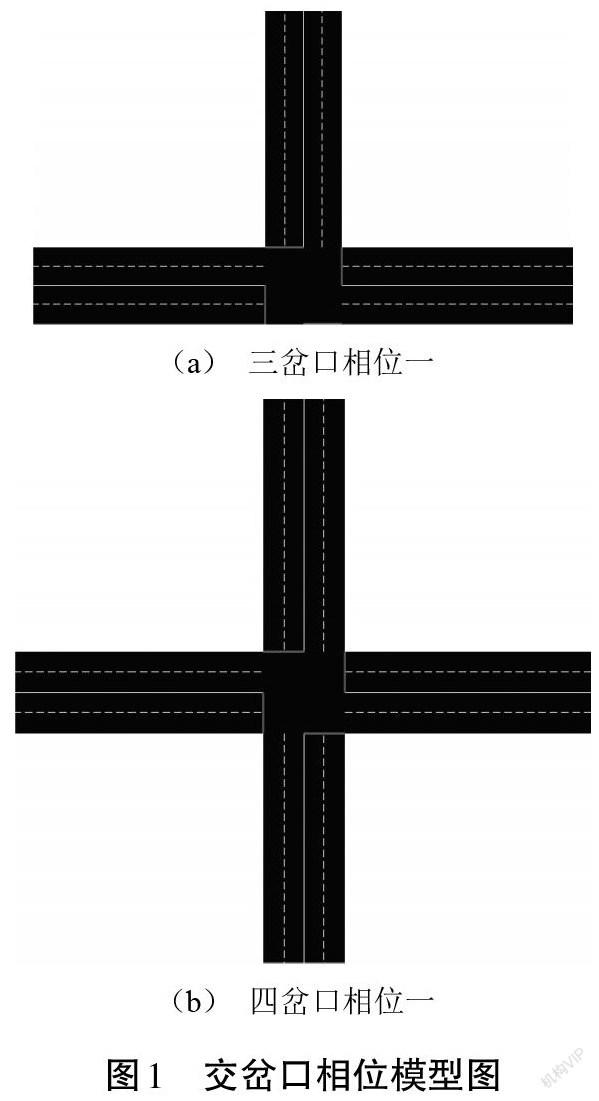
相位是对交通信号控制的简单描述。一般情况下,相位越大,交通越容易拥堵。相位一代表南北方向允许通行(南北方向绿灯),东西方向等待(东西方向红灯);相位二则与相位一相反。图1是一个三岔口和一个四岔口的相位模型的相位一(三岔口可以右转、四岔口南北方向绿灯)。……
