无序多分类logistic回归的SPSS软件实现及参数释义
2021-10-21李亚男仇丽霞李合欣赵丽娟
山西医科大学学报 2021年9期
李亚男,仇丽霞,李合欣*,赵丽娟
(1山西医科大学附属人民医院妇产科,太原 030012;2山西医科大学统计学教研室;*通讯作者,E-mail:851245745@qq.com)
在分类资料影响因素的研究中,我们常采用SPSS软件进行logistic回归分析,如果应变量为二分类变量,利用SPSS软件binary logistic过程实现,默认应变量赋值水平低者为参照水平且不可选择,默认分类自变量赋值最大者为参照水平[1],也可自行选择赋值最低者为参照水平,采用向前、向后或逐步筛选的方法建立最优的二值logistic回归模型[2,3]。但如果应变量是多项无序分类,SPSS软件multi logistic过程不能对变量进行筛选,只能建立全模型,而实际应用中,希望建立最优回归模型;而且该过程参照水平的设置、结果的输出都有别于二值logistic回归过程,其参数的解释难度更大[4,5]。本文利用山西省育龄人群二孩生育意愿的调查资料,建立无序多分类logistic回归模型,阐述利用SPSS26.0软件构建最优模型的建模策略及参数估计值的意义,为研究者提供SPSS软件实现的策略和参数解释的实例范本。
1 资料来源及研究方法
1.1 资料来源
收集2020年9月至2020年11月运用“问卷星”对山西省11个地市已育一孩的在婚、18-49周岁山西籍育龄人群二孩生育意愿及影响因素的调查数据,其中,已育一孩的在婚育龄人群共1 282人,有二孩生育意愿的410人。将调查对象的人口学特征共10个指标作为自变量(Xj),以二孩生育意愿作为因变量(Y1),变量赋值见表1,进行无序多分类logistic回归分析。
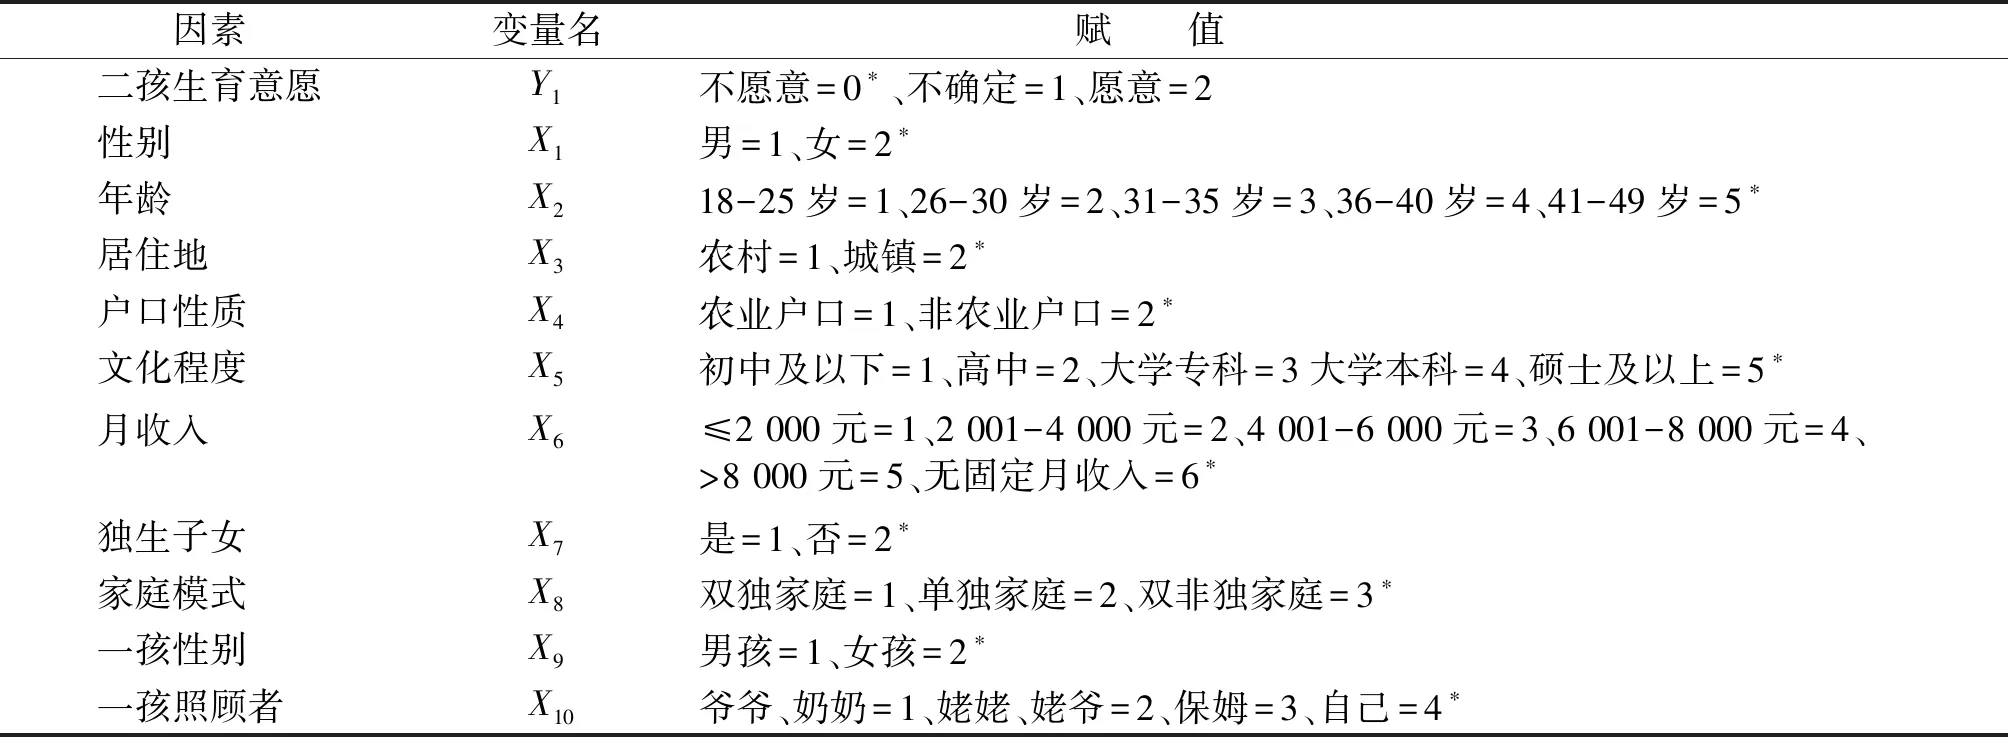
表1 已育一孩在婚育龄人群的二孩生育意愿及影响因素赋值