分布式云计算架构在区域医疗大数据分析中的优化研究
2021-08-24颜冰冰
智慧健康 2021年19期
关键词:优化
颜冰冰
(苏州市立医院北区 信息科,江苏 苏州 215000)
0 引言
在医疗信息化不断深入的背景之下,原本较为单一的数据信息也逐步变得更为多元化,这也给相关技术人员的处理利用提出了更高的要求,因此做好区域医疗数据信息的整合工作就显得尤为重要。这一举措不单单能够有效推动医疗数据更为标准化与规范化,也能够实现单一数据的有机融合以及从多个维度来进行分析汇总,进而为相关工作提供数据上的支持。
1 分布式云计算在医疗大数据分析中的架构
1.1 整合架构的设计
分布式云计算整体架构如图1所示。
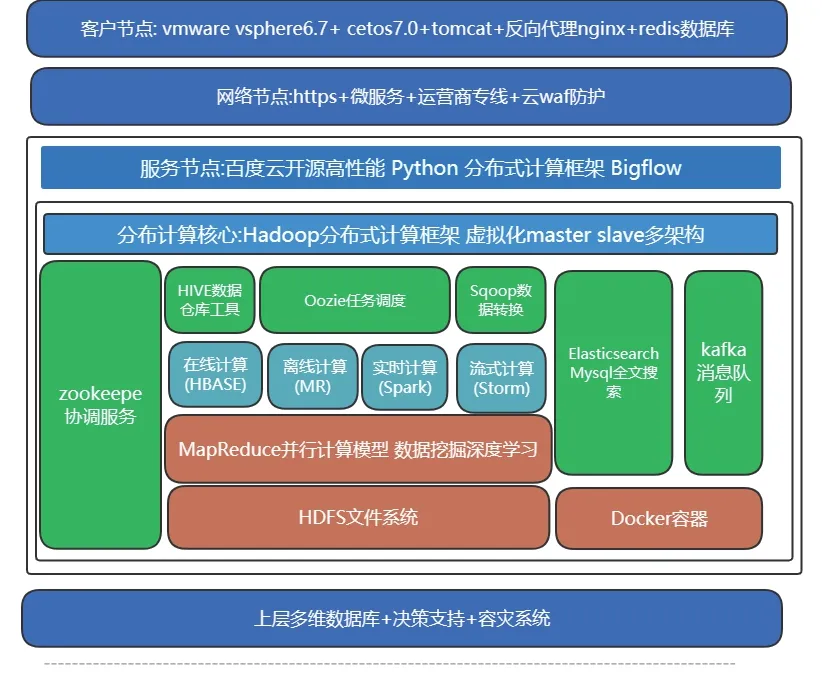
图1 整体架构设计示意图
客户节点包含了主流配置的两台物理服务器,并对其进行了内存容量的提升,医疗终端节点中的数据量分别由redis数据库、Tomcat服务、Nginx反向代理服务进行储存或利用,被架设于边界防火墙之中,所使用的带宽都不低于100M。每个医疗终端节点都和百度云分布式平台中的服务节点相连接,不同节点之间能够智能协同,且每个节点所采取的代码相同,能够执行在不同的引擎之中[1]。通过这一方式,无需明确Bigflow的实际计算与运行部位,只需要按照单机程序的编写来获取独特的逻辑,就会让Bigflow将这些计算分发到相应的执行引擎之上执行。Bigflow的目标是为了使分布式程序更简单,高效,维护更容易,迁移成本更小,进而实现分布式从架构到代码的环节尽可能精简的目的。在每个服务节点之间会按照线路建议申请电信运营商级别的CN2线路,以此来保障网络性能高速且稳定,同时实现最短最优通讯,具体如图2所示。……
登录APP查看全文