基于特征扩展的网构软件测试数据分类模型构建
2021-05-12王钰,刘磊
电子设计工程 2021年8期
王 钰,刘 磊
(北京科东电力控制系统有限责任公司,北京 100085)
目前,网构软件测试数据具有数量庞大、种类多、结构复杂等问题[1]。传统的数据分类方法对相近数据不能准确分类,给数据的搜索和查询带来困扰,将海量的网构软件测试数据进行精准划分成为当前数据管理的一大难题[2-3]。文中通过构建基于特征扩展的网构软件测试数据分类模型,明确模型的工作流程,采用特征扩展算法生成数据特征向量空间,通过计算数据的权值和表达能力准确分类,能够处理相近数据,根据数据的特征量进行准确分类,有助于加强对数据的管理且对数据的处理速度较快,适合未来互联网的发展。
1 网构软件测试数据分类模型
基于特征扩展的网构软件测试数据分类模型如图1 所示。
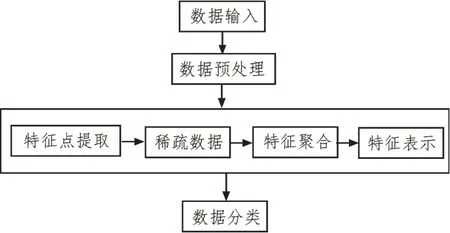
图1 网构软件测试数据分类模型
从图1 可以看出,对于网构软件测试数据,其特征分类包括以下步骤:
1)对于输入网构软件测试数据,提取其特征点,得到的数据特征点集合为F。
2)根据特征扩展算法,利用稀疏分解算法稀疏网构软件测试数据,得到的稀疏数据集合为D,集合F和集合D的关系为:F=nD。
3)聚合所有的稀疏数据,生成数据集W,则W=Pooling(F)。
4)采用平方根聚合方法对数据进行聚合处理,聚合计算的公式为:
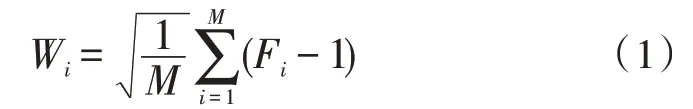
其 中,Wi表示稀疏数据W的第i个元素,m为输入网构软件测试数据中的特征点总数;Fi表示稀疏数据Wi在特征点集合F中的第i个特征点,在对所有稀疏数据进行聚合后,得到的数据稀疏向量表示为:
登录APP查看全文