基于知识库对齐的命名实体识别方法
2021-03-22鲁佩佩
电脑知识与技术 2021年4期
鲁佩佩
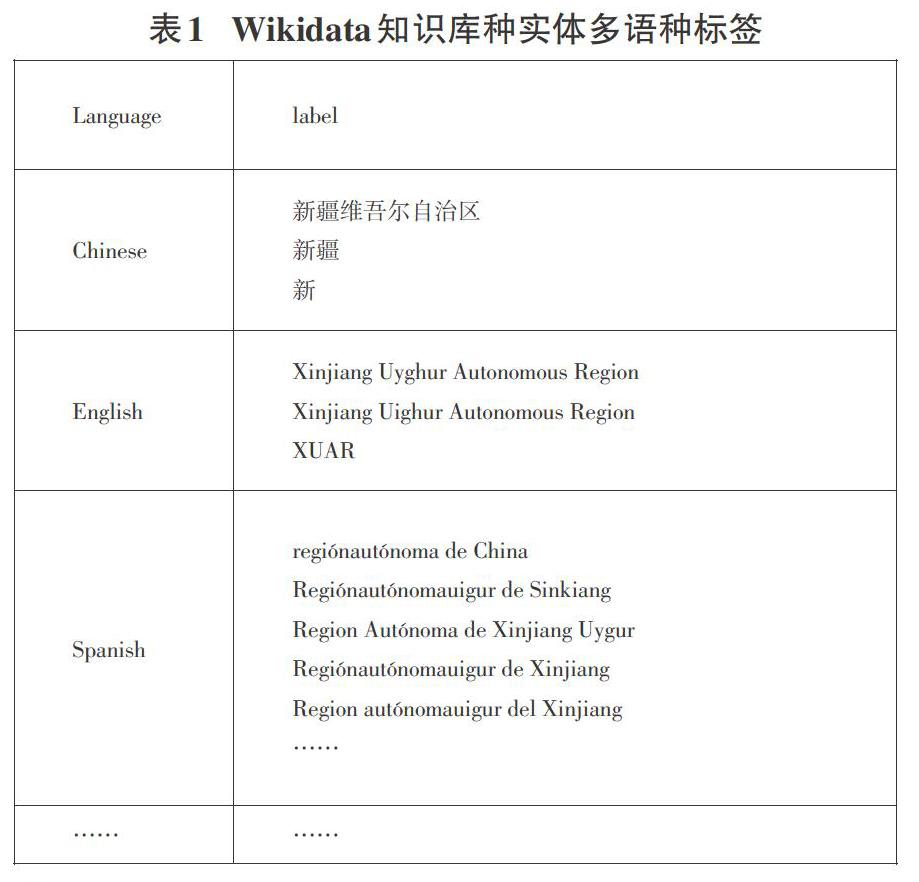


摘要:训练语料库的贫乏对低资源语种的命名实体识别效果有很大影响,高资源语种向低资源语种进行标签投影解决了低资源语种的语料问题。但由于词典的投影昂贵且单一,而Wikidata提供多语词条,一对多的标注投影极大地减少了投影产生的噪声,通过易获得的双语平行文本,基于Wikidata词条可构建多语种知识库,完成标签投影,构建训练语料库,提升低资源语种实体的识别功能。
关键词:低资源语种;知识库;命名实体识别;标签投影
中文图书分类号:TP393 文献标识码:A
文章编号:1009-3044(2021)04-0184-03
命名实体识别任务的研究从基于规则、基于统计到基于深度学习,虽然深度学习的研究方法在英文等语种的实体识别中有极优的效果,但是对于没有足够多标注数据的低资源语种来说,深度学习模型效果不理想。
对于低资源语种的命名实体识别,文献[1]主要实现了基于统计与规则相结合的人名通过条件随机场识别;文献[2]提出了基于学习的实体识别学习框架,向已有特定领域的模型进行学习,并迁移到任意神经网络模型,避免受到数据噪声的干扰;文献[3]使用并行数据将词性信息从资源丰富的语言传输到资源贫乏的语言使用少量带注释的数据来学习纠正错误,使用少量带标注的训练数据通过单词对齐进行标签投影来进行半监督学习。
本文将关系抽取中使用较广泛的远程监督方法应用到命名实体识别中,通过Wikidata[4]构建多语种知识库,基于知识库词条对实体标签投影。……
登录APP查看全文