基于深度学习的开放存取资源分类研究
2019-08-23邱盼
数字通信世界 2019年7期
邱 盼
(贵州财经大学,贵阳 550000)
1 引言
随着开放存取资源运动的迅速发展,开放存取资源逐渐成为建设数字图书馆不可或缺的数据源。其开放获取模式也为研究者提供了获取学术论文的新途径,有效促进了学术资源的共享。为了促进科学信息的广泛传播,学术信息的交流与发布,提高科学研究的程度,确保科学信息的长期保存。
近年来,深度学习作为机器学习的另一个分支,得到了广泛的研究和应用。 它通过使用由复杂结构或多个隐藏层感知器组成的多个处理层来替换具有高级数据抽象的手册。在文本分类任务中,基于文本分布式词向量表示的深度学习方法,卷积神经网络,循环神经网络等深度学习模型对文本进行分类可以获得更高的准确率。
本文将重点介绍基于深度学习的开放存取资源分类过程和Bi-LSTM 模型和Text-CNN 模型。
2 开放存取资源文本分类实现
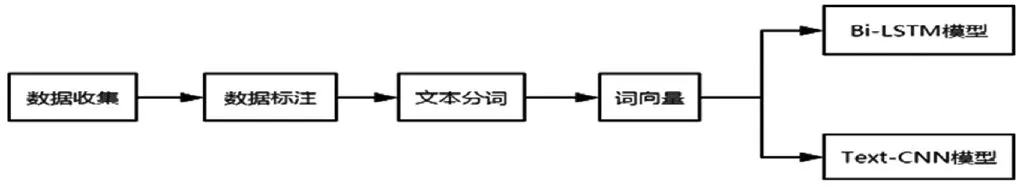
图1
2.1 数据收集
现在的开放存取资源有多个平台,本文选择Worldlib 获取数据,worldlib 国外文献整合平台整合了国外各种开放数据,文献数量近千万篇,以英语为主,学科覆盖范围为全学科。本文采用python 爬虫来获取开放存取资源。Python 爬虫相对Java,C++是比较简单易上手的。
2.2 数据标注
数据标注意味着人们判断和标注数据集内的每一条数据根据数据分类规则,找到预测的目的目标y。标注的主要原因是基于深度学习的训练和测试过程需要使用带安全标注的数据。在训练过程中,需要将训练集的数据和数据类别作为学习材料,供计算机学习、处理和构造神经网络模型中的意义。……
登录APP查看全文
