基于属性优先关系的多用户Skyline查询处理算法
2018-08-07邵路伊王沁雪
计算机与现代化 2018年7期
关键词:用户
邵路伊,王沁雪,郭 帅
(南京航空航天大学计算机科学与技术学院,江苏 南京 210016)
0 引 言
Skyline查询作为一种新的数据库操作符在2001年被提出[1],从此,它得到了研究者的广泛关注。Skyline查询为多目标决策、数据挖掘等问题提供了解决途径,有助于人们更好地做出决策。然而,随着数据集的增大以及数据维度的增加,Skyline查询返回的结果集仍旧很大,对用户的参考意义不大。同时,在现实生活中,真实数据集的各个属性的相对重要程度可能不同。例如一套房子的属性有面积、价格、所在学区、交通便利性和绿化环境等,当用户选择购买房子时,可能会最看重所在学区的排名,然后再对比价格和面积,而对绿化环境等其他因素没有要求,因此房子所在学区这一属性比其他属性对于用户的决策更有决定性作用,即它的优先等级更高。因此,数据集属性之间的优先关系能更具体地体现用户的偏好。
针对上述问题,研究者对偏好Skyline查询展开研究,关注数据集属性之间的相对重要性[2]。研究者们提出一些新的支配关系和算法[3-7],根据属性优先关系改变数据点之间的支配关系,使Skyline结果集的规模发生变化,同时使查询结果更符合用户提出的偏好需求。目前已有的偏好Skyline查询均是在单用户场景下研究的,而在实际应用中,往往需要考虑多用户参与的情况。
表1 房子数据集信息示例
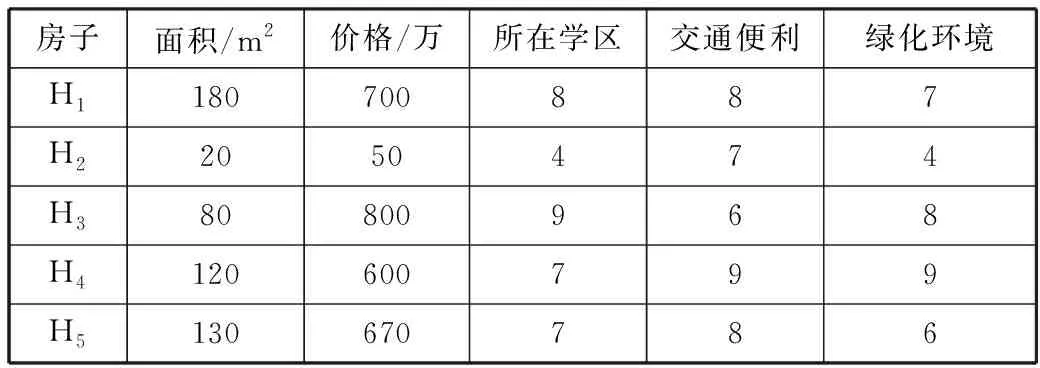
房子面积/m2价格/万所在学区交通便利绿化环境H1180700887H22050474H380800968H4120600799H5130670786
例1一个家庭共同考虑购买一套房子,房子的数据信息如表1所示。……
登录APP查看全文
