从WOS地址字段提取二级机构数据的半自动数据清洗方法
2017-09-06何春建
何春建


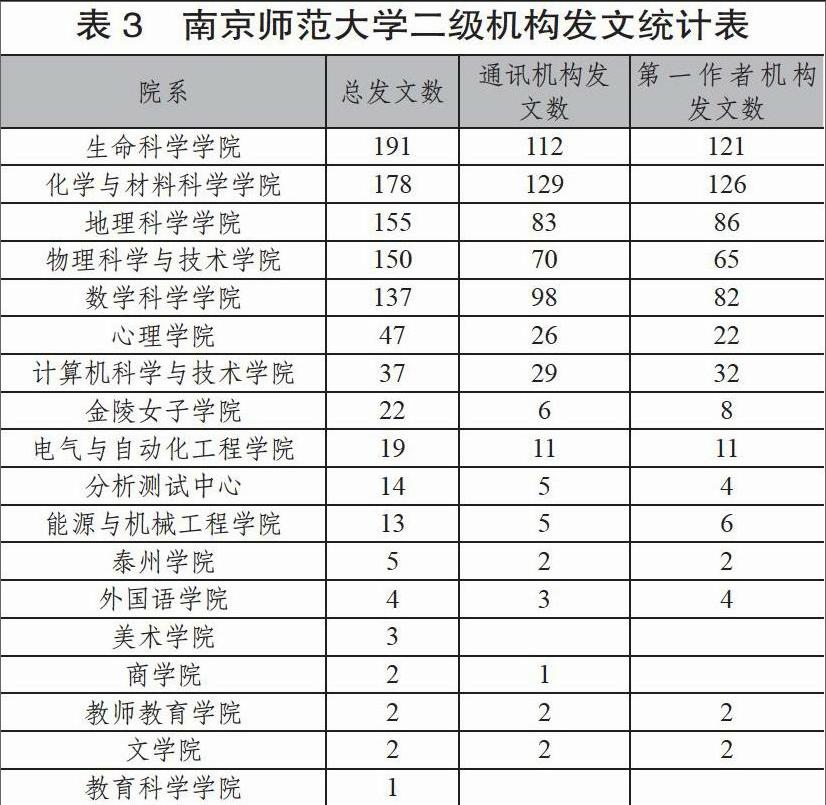
摘 要 各高校都需要统计本校各个二级机构Web of Science (WOS)发文情况,论文提出一种基于正则表达式的半自动数据清洗方法,可从WOS地址字段中提取出发文机构排名、所属二级机构名称以及对应作者群,并以2015年南京师范大学WOS发文统计为例,进行实证研究,分析出各院系发文情况和作者发文情况。
关键词 二级机构 正则表达式 数据清洗 WOS地址字段 科技查新
分类号 G250.78
DOI 10.16810/j.cnki.1672-514X.2017.08.012
A Semi-automatic Data Cleaning Method for Extracting Secondary Institutions Data from WOS Address Field
He Chunjian
Abstract Chinese higher education institutions need to count the articles included in Web of Science (WOS) by their secondary institutions. This paper puts forward a semi-automatic data cleaning method based on regular expressions for extracting ranking of the dispatch agency, name of the secondary institutions and the corresponding authors from WOS address fields. At last, it takes the statistics of articles included in WOS of Nanjing Normal University in 2015 as an example to conduct an empirical study, and analyze the situation of the articles issued by various faculties and authors.Keywords Secondary institutions. Regular expression. Data cleaning. WOS address field. Sci-tech novelty search.
0 引言
Web of Science(WOS)不仅是世界范围内最权威的科技文献索引工具之一, 也是科研评价的一种依据。科研机构被WOS收录的发文总量及被引用次数, 反映整个机构的科研, 尤其是基础研究的水平。各高校均需对本校WOS发文进行统计,这些WOS论文的收录及被引情况是机构内部重要的考核指标。而在统计这些WOS论文的时候,需要将检出的所有文献全部准确地划分到各个二级机构,最终归属到具体作者,以便主管部门全面了解各院系科研情况并统计考核教职工的科研工作。然而直接从WOS数据库下载的数据中没有专门的二级机构字段。二级机构的信息包含在地址字段中,所以需要对地址字段进行数据清洗,以便准确快速地获取二级机构的信息。
梁桂英等[1]研究了如何构建非特异性机构论文检索式,丁海德等[2]研究了地址信息著录差异与错误分析,苗艳荣、房文革[3-4]研究构建合适的机构检索式,兼顾查准率与查全率,这些文献的焦点均是查准查全一级机构发文,没有关注二级机构。张晋辉等[5]提出一种SCI地址字段数据清洗方法,也不以二级机构为研究对象。……