改进蚁群算法在支持向量机参数中的应用
2015-01-13刘继承隋殿雪
刘继承 解 敬 隋殿雪
(东北石油大学电气信息工程学院,黑龙江 大庆 163318)
1 SVM的基本思想与参数①
SVM是一种基于统计学习理论的模式识别方法[3],其基本思想是通过核函数将样本空间映射到特征空间,在特征空间中寻求原样本的最优分类面,得到输入变量和输出结果之间的一种线性或非线性关系[4],即寻找SVM进行模式分类[5]。
对线性可分的样本集(xi,yi)(i=1,2,…,n,n为学习样本数目),xi=Rd表示输入变量,yi∈[-1,+1]为输出变量。利用非线性映射φ(·),将输入空间的数据映射到高维特征空间,并构造最优分类超平面:
f(x)=w·φ(x)+b=0
(1)
式中b——阈值;
w——权值矢量。
为了使结构风险最小化,分类应满足以下约束:
yi[(w·xi)+b]-1≥0,i=1,2,…,n
(2)
对于线性不可分的问题,引入松弛变量ξi来构建最优超平面。允许在一定程度上违反间隔约束优化问题,则有:

(3)
yi[(w·xi)+b]≥1-ξi,ξi≥0,i=0,1,…,n
(4)
此时根据核函数理论,应存在核函数K=(x,x′)=[Φ(x),Φ(x′)],从而使:
(5)
(6)
C≥αi≥0,i=1,2,…,l
(7)
其中,C为误差的惩罚参数,αi>0对应的点是支持向量。进而构造出决策函数:

b*)
(8)
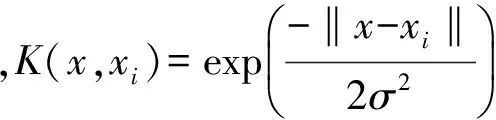
SVM参数的确定影响其学习和推广能力[6]。对于RBF核函数的SVM来说,其参数包括惩罚参数C和核宽度σ。惩罚参数C是在结构风险和样本误差之间的折衷,其值越大,允许的误差越小;核宽度σ与学习样本的输入空间范围或宽度有关,样本的输入空间越大,σ取值越大。
2 改进蚁群算法优化SVM参数
由于蚁群算法全局优化参数的时间较长,为了减少优化参数的时间,笔者有效结合了交叉验证法和蚁群算法来优化SVM参数,最终达到理想的识别效果。
2.1 交叉验证法
首先将数据分成n个同样大小的子集;然后选取n-1个子集作为训练样本,预测那个没有参加训练的子集,共进行n次,将全部数据中的每个样本点都预测一遍,但准确率并不是很稳定;最……