基于GMM的听觉场景识别算法研究
2021-12-22刘明曾伟浩
科技信息·学术版 2021年2期
刘明 曾伟浩
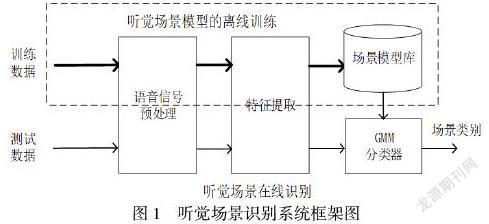
摘要:佩戴助听器的听力患者像正常人一样生活在安静的卧室、嘈杂的道路或音乐会等各种环境中。有些助听器算法只适用于一个场景,但在另一个场景可能没有效果,甚至带来更糟糕的结果。有些助听器需要患者根据不同的环境手动调整一些参数,通过音量调节开关来控制输出音量,以适应当前的环境,获得更好的声音。而且,一次设置后,佩戴后不可能一直手动调整,手动选择功能对于老年人、儿童或残疾人等弱势群体非常不方便。如果助听器使用算法自动识别场景,自动设置参数以适应当前环境,并自动增益输出音量,而不是人工操作的繁琐部分,将大大提高助听器的智能化程度。
关键词:助听器 自动识别场景 自动增益
一、引言
听佩戴数字助听器的听障患者通常处于各种听力环境中,如言语、噪音或音乐等[1]。为了获得最佳的听觉体验,在早期的数字助听器中,数字助听器厂商会将适合各种场景的程序预刻录到芯片中,通过拨动开关选择相应的程序,即不同的频率响应或其他处理选项,如麦克风阵列语音增强、噪声抑制、宽动态压缩和回声消除等[2]。用户需要确定他们所处的环境,并手动切换开关来选择与场景相对应的节目。然而,对于听障患者来说,识别当前环境并选择与场景相对应的节目是一项非常困难的任务。即使对于一个听力健康的人来说,也不清楚选择哪个节目来匹配当前的场景。……
登录APP查看全文