基于Kubernetes的海量网络数据存储方法研究
2021-11-08闫娟雅
电脑知识与技术 2021年27期
关键词:数据存储
闫娟雅
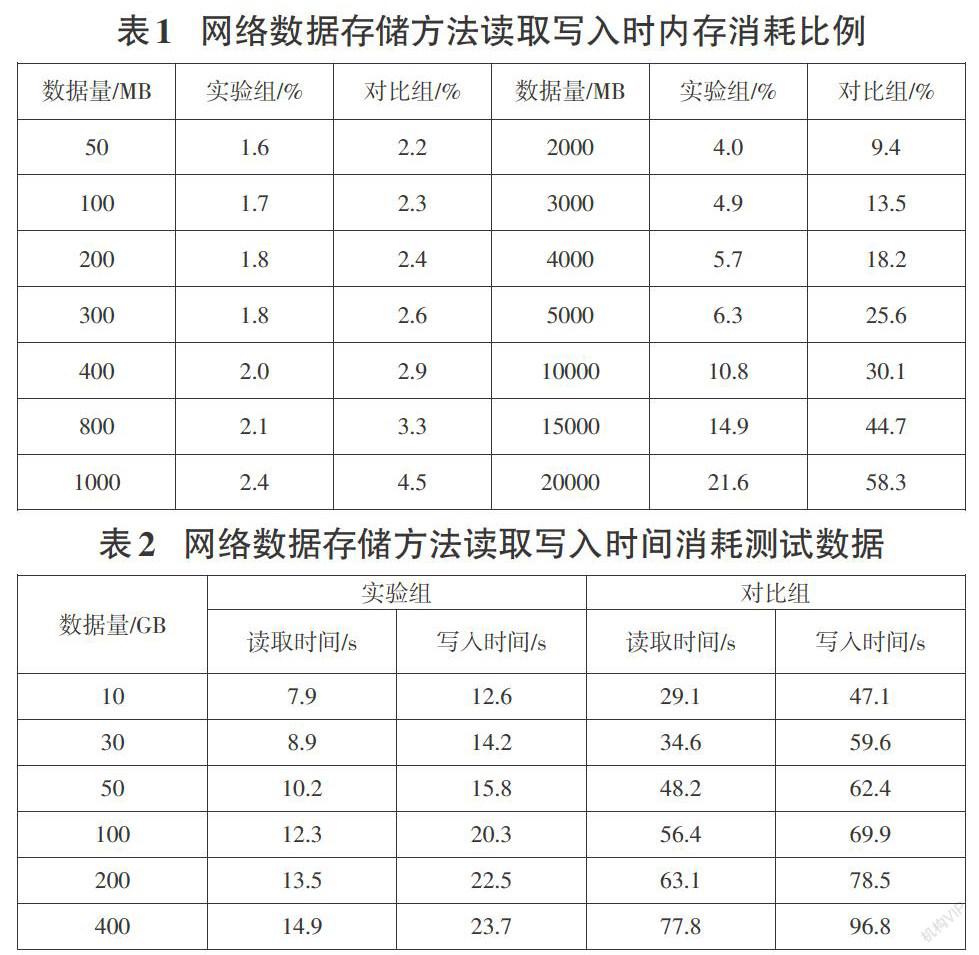
摘要:针对传统的集中式网络数据存储方式存储数据效率低的问题,研究了基于Kubernetes的海量网络数据存储方法。对海量网络数据动态合并处理后,设计Kubernetes集群并部署外部上传端与Kubernetes服务的访问过程,从而实现对海量数据的存储。对比实验结果显示,该存储方法相比能够减少约62%的运算内存占用,并且存储操作速度快,更能满足实际需求。
关键词:Kubernetes;海量数据;网络数据;数据存储
中图分类号:TP392 文献标识码:A
文章编号:1009-3044(2021)27-0028-02
Kubernetes是用于管理云平台中多个主机上的容器应用部署方式[1]。相比于传统系统绑定并通过插件、脚本或者沉重的虚拟机来安装应用的应用部署方式,Kubernetes可以通过部署互相隔离的存储容器的方式,在避免不同数据进程互相干扰的同时,还能利用容器各自的文件系统有效区分计算资源。将Kubernetes应用于网络海量数据存储中,能够改善集中式数据存储方法并发率低的问题。因此,本文将研究基于Kubernetes的海量网络数据存储方法,并对该方法的可行性进行验证。
1 基于Kubernetes的海量网络数据存储方法研究
1.1 海量网络数据动态合并处理
网络海量数据因网络的互联互通特殊性,网络中的数据大多存在一定的相关性。为节省数据存储过程中占用的内容,需要对网络海量数据进行动态合并处理。在本研究中,使用子集检测的频繁项挖掘算法,找出存在关联关系的网络数据,从而实现网络海量数据的动态合并,提高网络海量数据的访问速度,减少数据存储过程中的输入输出次数[2]。……
登录APP查看全文
