Audio2Face基于音频文件智能生成虚拟角色面部动画
2021-09-27蔡国鑫
近日英伟达 (Nvidia)公司发布了一款基于人工智能 (AI)的Audio2Face应用程序,根据音频源生成3D 虚拟角色面部动画并实现唇音同步,可用于实时交互应用或作为内容创作通道。传统虚拟角色面部动画制作需进行建模、绑定、动画等一系列处理,而Audio2Face以.wav或.mp3音频文件为输入,直接生成角色面部动画或几何缓存,制作人员只需根据应用需求进行调整定制即可使用。
1 Audio2Face技术难点与解决方案
仅由音频源生成虚拟角色面部动画和实现唇音同步的难点在于基于同一音频源可能生成多种不同的面部动画。尽管深度卷积神经网络 (DCNN)在各种推理和分类任务中非常有效,但如果训练数据中存在歧义,其往往会向均值回归,因此基于深度卷积神经网络为虚拟角色生成逼真且一致的面部动画尚存在一定困难。
针对技术难点,Audio2Face提出了以下解决方案:
(1)设计一种深度卷积网络,用于有效处理人类语音并在不同的虚拟角色上实施模型泛化。
(2)采用一种新颖方法,使网络能够发现训练数据中不能由音频单独解释的变化,即明显的情绪状态。
(3)构建具有三个损失项的损失函数 (Loss Function),确保在数据高度模糊的情况下,网络依然能够具有时间稳定性和快速响应能力。
2 Audio2Face网络结构
按照功能划分,Audio2Face网络由频率分析网络(Formant Analysis Network)、发音网络 (Articulation Network)和输出网络 (Output Network)组成,网络结构如图1所示。
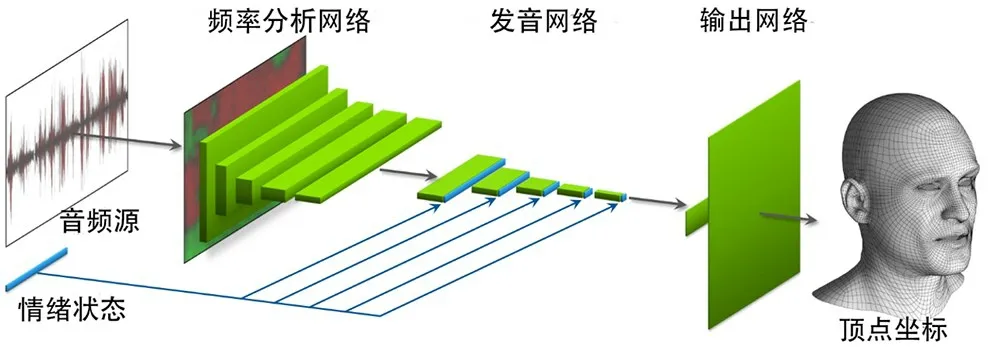
图1 Audio2Face网络结构
频率分析网络 (Formant Analysis Network)包括一个固定功能的自相关分析层 (Fixed-Function Autocorrelation Analysis Layer)和5 个卷积层。自相关分析层使用线性预测编码 (Linear Predictive Coding,LPC),以提取音频的自相关系数。……
