基于自适应MMSE-LSA与NMF的语音增强算法
2021-09-10马振中
董 胡,刘 刚,2,马振中
(1.长沙师范学院信息科学与工程学院,湖南 长沙 410100; 2.中南大学物理与电子学院,湖南 长沙 410012)
0 引言
语音增强是提高含噪语音信号质量和清晰度的重要步骤,为了更好地理解含噪语音信号,需要一种语音增强技术来去除环境中的噪声。在以往的文献中,各种各样的语音增强技术都被用于降噪。虽然抑制背景噪声和改善语音质量的语音增强算法的开发已经取得了一定的进展,但在提高语音清晰度和可懂度的算法方面仍需进一步改善。
近年来,相关研究者提出了一些低信噪比[1-2](<6 dB)环境下的语音增强算法。文献[3]提出基于单麦克风信道的语音增强算法,与传统的单通道语音增强方法相比,该算法具有较好的语音增强性能,但它不适用于快速变化的非平稳噪声。文献[4]和文献[5]分别提出基于波形网络、生成对抗网络的语音增强算法,这两种算法能较好地将目标语音与混合语音分离,但这两种算法的计算复杂度较高,对内存资源的要求较高。目前常用的谱减法、维纳滤波法、最小均方差估计法在去除背景噪声方面有一定的效果,但有时会造成语音失真或产生音乐噪声[6-8]。其中,幅度谱估计算法中的对数谱最小均方误差估计算法(minimum mean square error of log-spectral amplitude estimator, MMSE-LSA)[9-11]具有较好的语音保真度,因此得到广泛的关注;然而,传统MMSE-LSA算法无法依据输入信号的信噪比对增益因子作自适应调整,在输入信号的信噪比变化的条件下,该算法性能不稳定。非负矩阵分解(nonnegative matrix factorization, NMF) 算法对语音与噪声作非负矩阵分解获得相应字典矩阵,测试阶段将混合信号幅度谱分解为字典矩阵与权重矩阵的乘积;最后通过语音字典及权重矩阵乘积重构增强后语音[12-14]。本文针对上述问题,提出了基于自适应MMSE-LSA与NMF的语音增强算法。
1 自适应MMSE-LSA算法
MMSE-LSA算法对语音增强涉及先验信噪比与后验信噪比的估算问题[15]。伴随着对噪声估计结果的变化,需对信噪比作适时更新,由于在先验信噪比的估算过程中引入了调节因子α′,通常对其设定一个范围,再依据多次实验结果来确定一个经验值。然而,这种通过实验来确定经验值的方法,对于不同信噪比的情况可能会造成语音失真或产生音乐噪声问题,因此需对α′值作及时更新[8]。自适应MMSE-LSA算法则采用先验信噪比的最小均方差,依据噪声变化获得α′在不同信噪比情况下的自适应最优值。
x(n),d(n)和y(n)分别代表纯净语音、噪声及含噪语音,有:
y(n)=x(n)+d(n)
(1)
式(1)经FFT变换后可得下式:
|Y(n,k)|2=|X(n,k)|2+|D(n,k)|2
(2)
式(2)中,|Y(n,k)|2,|X(n,k)|2,|D(n,k)|2分别为含噪语音、纯净语音及噪声短时谱幅度。
Y(n,k)=|Y(n,k)|∠θy
(3)
X(n,k)=|X(n,k)|∠θx
(4)
式(3)、式(4)中,∠θx和∠θy代表相位。
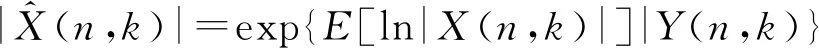
(5)
|X(n,k)|=G(n,k)|Y(n,k)
(6)
(7)
式(7)中,ξ(n,k)为语音信号第n帧的第k个频率点先验信噪比,其定义如下:
(8)
(9)
从式(7)可知,计算增益函数须获得先验信噪比,进而才能估计出纯净语音,能否准确估计出先验信噪比对语音增强效果有重要影响。……
