基于企业应用的K-means算法的实现与改进
2021-08-18罗俊
电脑知识与技术 2021年18期
罗俊


摘要:K-Means算法,也称为K-均值,是数据挖掘研究中是一种最基本的算法,也是应用最广泛的聚类算法。在电子商务、入侵检测、CRM等领域有较多的应用实例。它是一种cluster analysis的算法,其实现主要通过不断循环迭代地选取离种子点最近均值的过程。本文结合企业实际应用阐述k-means的实现过程、具体的改进思路以及应用价值,聚类模型的建立对企业具有较强的实际意义。
关键词:电子商务;聚类;算法改进;K-means算法
中图分类号:TP311 文献标识码:A
文章编号:1009-3044(2021)18-0029-03
开放科学(资源服务)标识码(OSID):
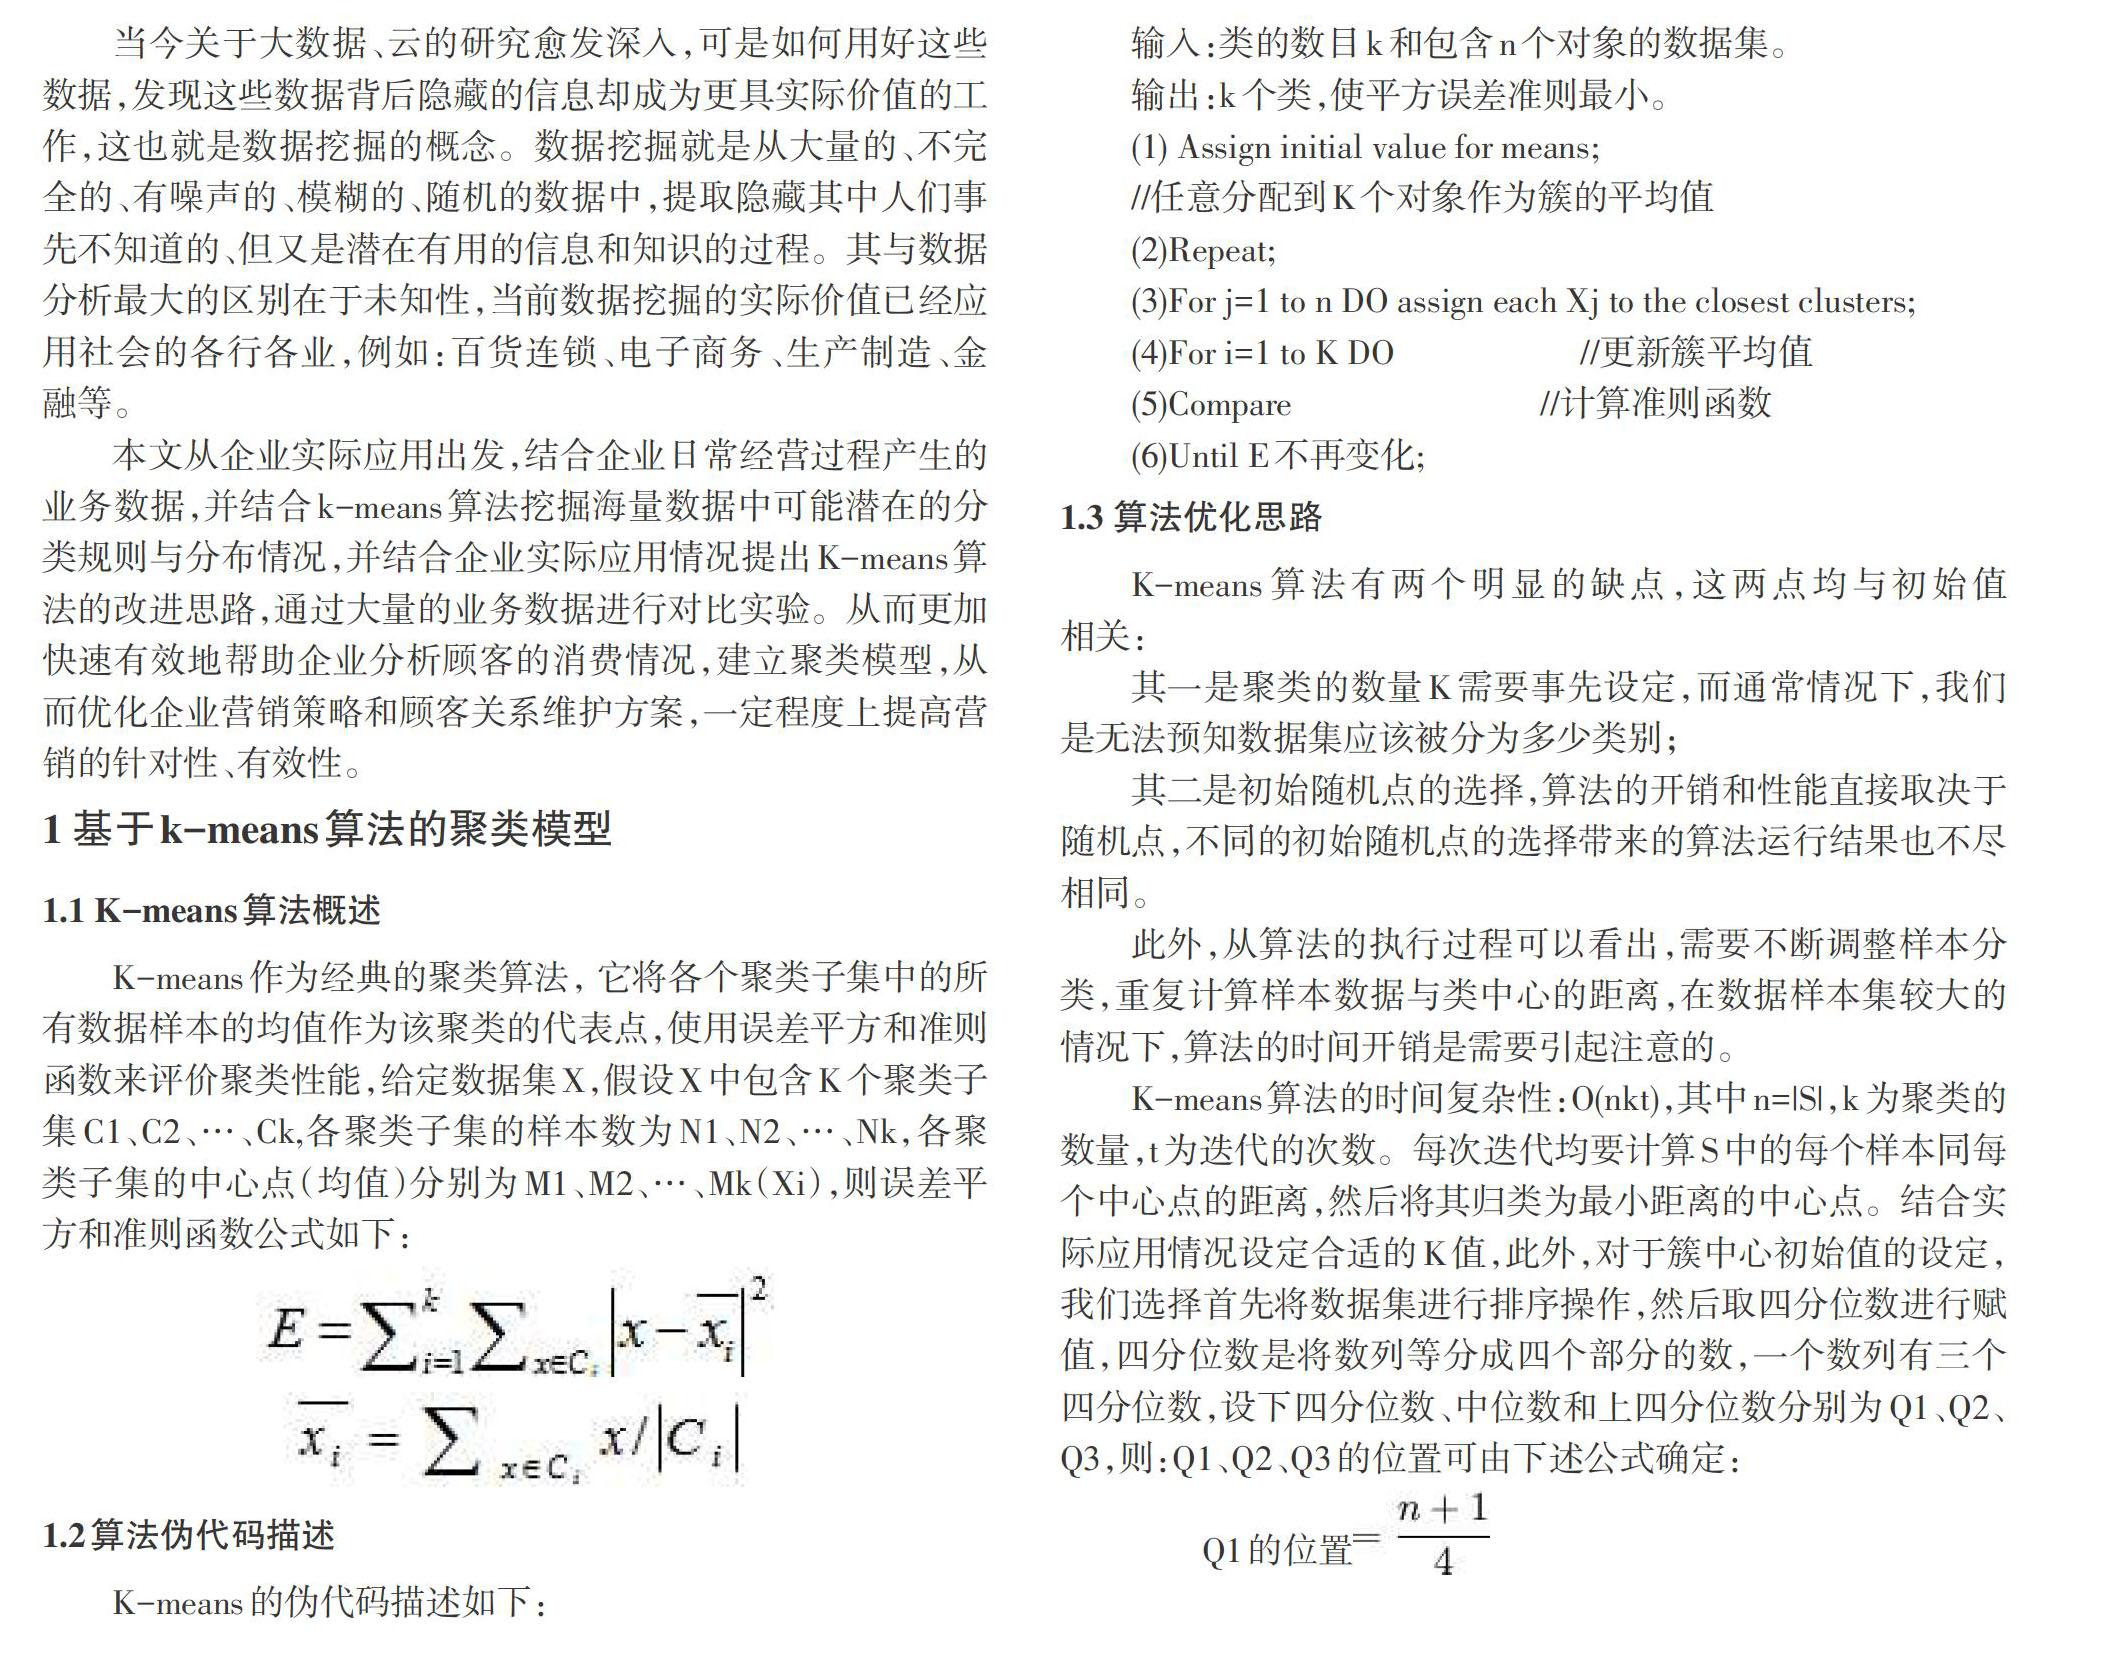
当今关于大数据、云的研究愈发深入,可是如何用好这些数据,发现这些数据背后隐藏的信息却成为更具实际价值的工作,这也就是数据挖掘的概念。数据挖掘就是从大量的、不完全的、有噪声的、模糊的、随机的数据中,提取隐藏其中人们事先不知道的、但又是潜在有用的信息和知识的过程。其与数据分析最大的区别在于未知性,当前数据挖掘的实际价值已经应用社会的各行各业,例如:百货连锁、电子商务、生产制造、金融等。
本文从企业实际应用出发,结合企业日常经营过程产生的业务数据,并结合k-means算法挖掘海量数据中可能潜在的分类规则与分布情况,并结合企业实际应用情况提出K-means算法的改进思路,通过大量的业务数据进行对比实验。从而更加快速有效地帮助企业分析顾客的消费情况,建立聚类模型,从而优化企业营销策略和顾客关系维护方案,一定程度上提高营销的针对性、有效性。……
登录APP查看全文