基于朴素贝叶斯的敏感信息识别方法研究
2021-07-16陆向艳苏崇刘峻
网络安全技术与应用 2021年7期
◆陆向艳 苏崇 刘峻
(1.广西大学计算机与电子信息学院 广西 530004;2.广西师范大学广西多源信息挖掘与安全重点实验室 广西 54100)
互联网经过20 多年的发展,已经深入渗透到社会生产、生活和学习等领域的各个方面,互联网各种平台上每天产生大量的文本信息,其中有些信息不加以辨别和控制会对政治、经济和道德等领域造成损害或影响。这些信息主要包括政治敏感信息、恐怖信息、色情信息、侮辱谩骂信息、恶意广告信息等[1],被统称为敏感信息。如果不及时识别和处理这些敏感信息,互联网环境将不断地遭受破坏,给社会稳定、安全和文明等方面造成不利影响,识别并过滤敏感信息成为当前净化网络环境的重要手段。由于互联网信息量巨大,当前主要采取自动化方法来识别敏感信息。自动识别敏感信息方法主要为基于机器学习的分类方法,当前研究主要有基于SVM、决策树、K 近邻等[2-5]方法,本文提出一种基于朴素贝叶斯的敏感信息识别方法,旨在为敏感信息识别提供方法参考。
2 基于朴素贝叶斯的敏感信息识别方法
2.1 方法模型
基于朴素贝叶斯的敏感信息识别方法包括敏感信息标记、文本分词、朴素贝叶敏感词训练、朴素贝叶斯敏感信息分类4 个步骤,方法模型如图1 所示。
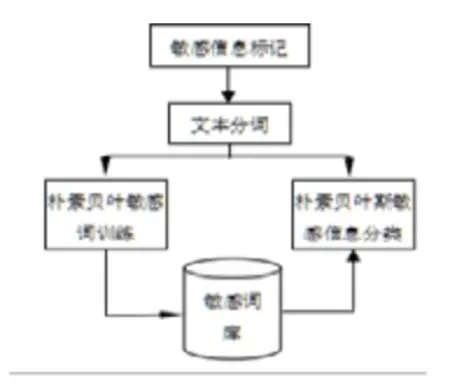
图1 模型图
2.2 敏感信息标记
用爬虫软件收集文本数据集,取其中一部分进行文本敏感属性标记,将包含和不包含敏感信息的文本分开存放。将敏感数据集分成涉黄、涉政、涉恐、广告、谩骂五个类别进行分类标记。……
登录APP查看全文
