豆瓣大连电影票信息爬取与存储
2021-07-04孙爱婷
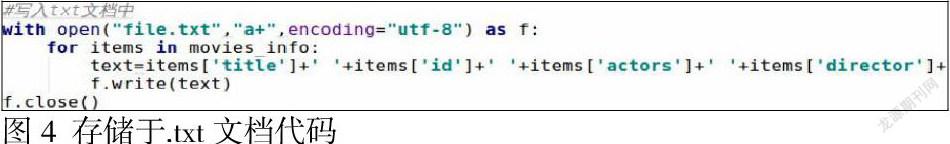
摘 要:针对爬取工作量较重,分析内容繁杂的网站而言,利用正则表达式的re模块实现爬虫是较困难的,此时需要更高效的BeautifulSoup分析工具來解决这一问题。爬取豆瓣电影票-大连城市网站中的全部电影列表,首先进行网页源代码分析,采用python自带的html.parser解析器解析网页,爬取所需电影信息,然后采用5种不同方式进行存储,方便进行不同需求的数据挖掘和分析。
关键词:网页爬取;BeautifulSoup;解析器
一、BeautifulSoup
BeautifulSoup是网络爬虫必学的技能之一,是一个可以从HTML或XML文件中爬取数据的python库。BeautifulSoup主要功能是从复杂的网页解析和爬取HTML或XML内容,哪怕此时使用BeautifulSoup实现的是海量的网站源码的分析工作,我们会发现,它的实现过程也非常简单,极大地提高了分析源码的效率。
同时,BeautifulSoup支持Python标准库中的HTML解析器,还支持一些第三方库的解析,如果不进行特殊的解析器安装,Python则会使用默认的解析器。基于以上特性,BeautifulSoup已成为和Lxml一样出色的Python解析器,为用户灵活提供不同的网站数据爬取和解析策略。
二、基于BeautifulSoup的独立数据爬取
1.实例分析
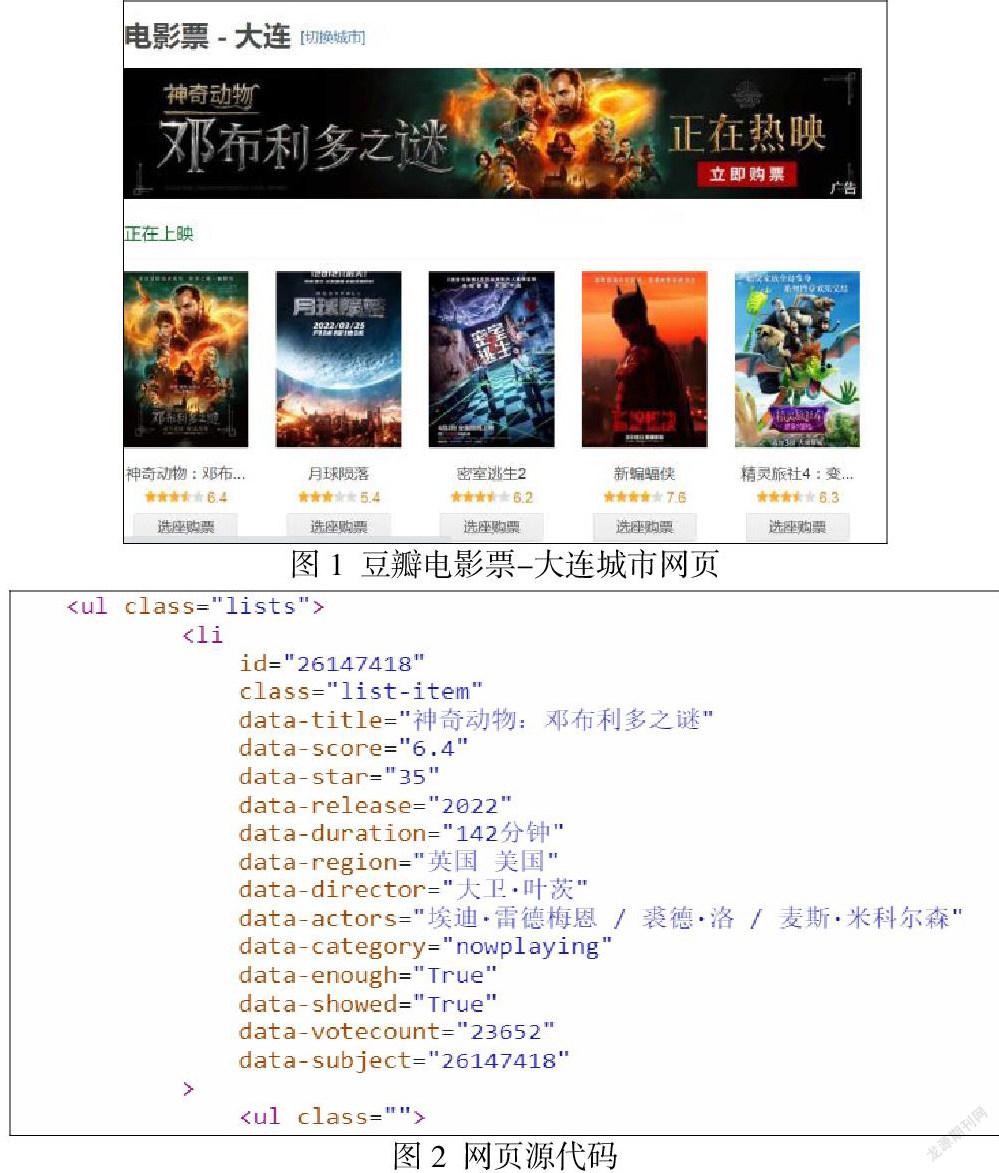
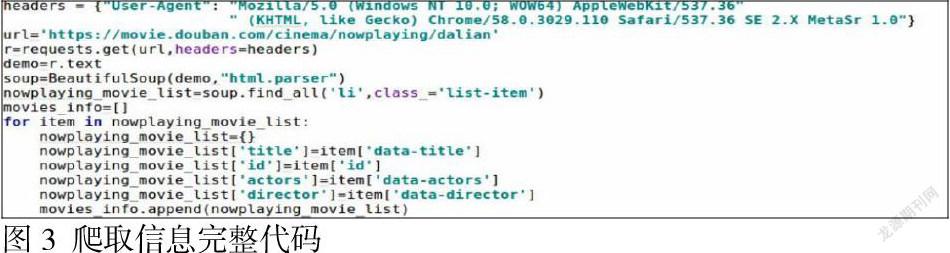
本实例的爬取目标是豆瓣电影票-大连城市网站中的全部电影列表,网站内容见图1,网站地址如下:https://movie.douban.com/cinema/nowplaying/dalian/,部分网页源代码如图2所示,需要说明的是,由于网站内容不断地动态更新,因此每次运行得到的结果可能会有差异。
2.源代码分析
我们的目标是电影列表,首先从图2中搜索到目标位置,然后通过“soup.find_all(‘li’,class_=’list-item’)”,找到全部class_属性为“list-item”的<li>标签,爬取需要的电影信息。例如,item[‘data-title’]获取<li>标签中的指定属性data-title(电影名)对应的value值,item[‘id’]对应属性id(电影ID)的value值等,最后依次爬取需要的内容即可。……