基于多损失值融合神经网络的语音增强研究
2021-04-22朱世宇李根孙令翠谢箭柏森孟宓
数字技术与应用 2021年2期
关键词:模型
朱世宇 李根 孙令翠 谢箭 柏森 孟宓
(1.重庆工程学院,重庆 400056;2.重庆电讯职业学院,重庆 402274)
0 引言
多个研究中指出,增强后语音均方差损失值得分较小的语音(与相对应干净语音相比)不能保证其具有高语音质量和高可懂度[1-2],均方差损失函数,其缺乏与人类听觉感知系统或人类听觉间的关联。对语音增强神经网络损失函数的改进,能提高语音增强神经网络性能,从而解决其受损失函数制约性能的问题。
本研究中提出的多损失值损失函数,由经过训练的语音生成对抗神经网络中的判别网络,融合均方差损失函数构成。在判别网络损失函数基础上,使用均方差损失函数,保证了增强语音与干净语音间的相关性。
此外本研究中提出的基于多损失值融合神经网络,使用音频波纹数据作为输入,在较多语音增强神经网络模型中,使用语音频域信息作为输入[3-4],语音音频数据与语音频域数据转换过程,并非完全可逆,转换过程中语音音频部分细节信息(例如相位信息)丢失[5]。直接使用音频波纹数据作为输入,保留了音频数据的细节信息。为保证语音音频细节信息在卷积网络层间的流动,在卷积网络特定层间添加跳连结构,使相位、校正等语音音频细节信息,不经过卷积网络进行特征抽取压缩,直接在各卷积网络层间流动。也进一步避免了语音音频细节信息丢失的问题。
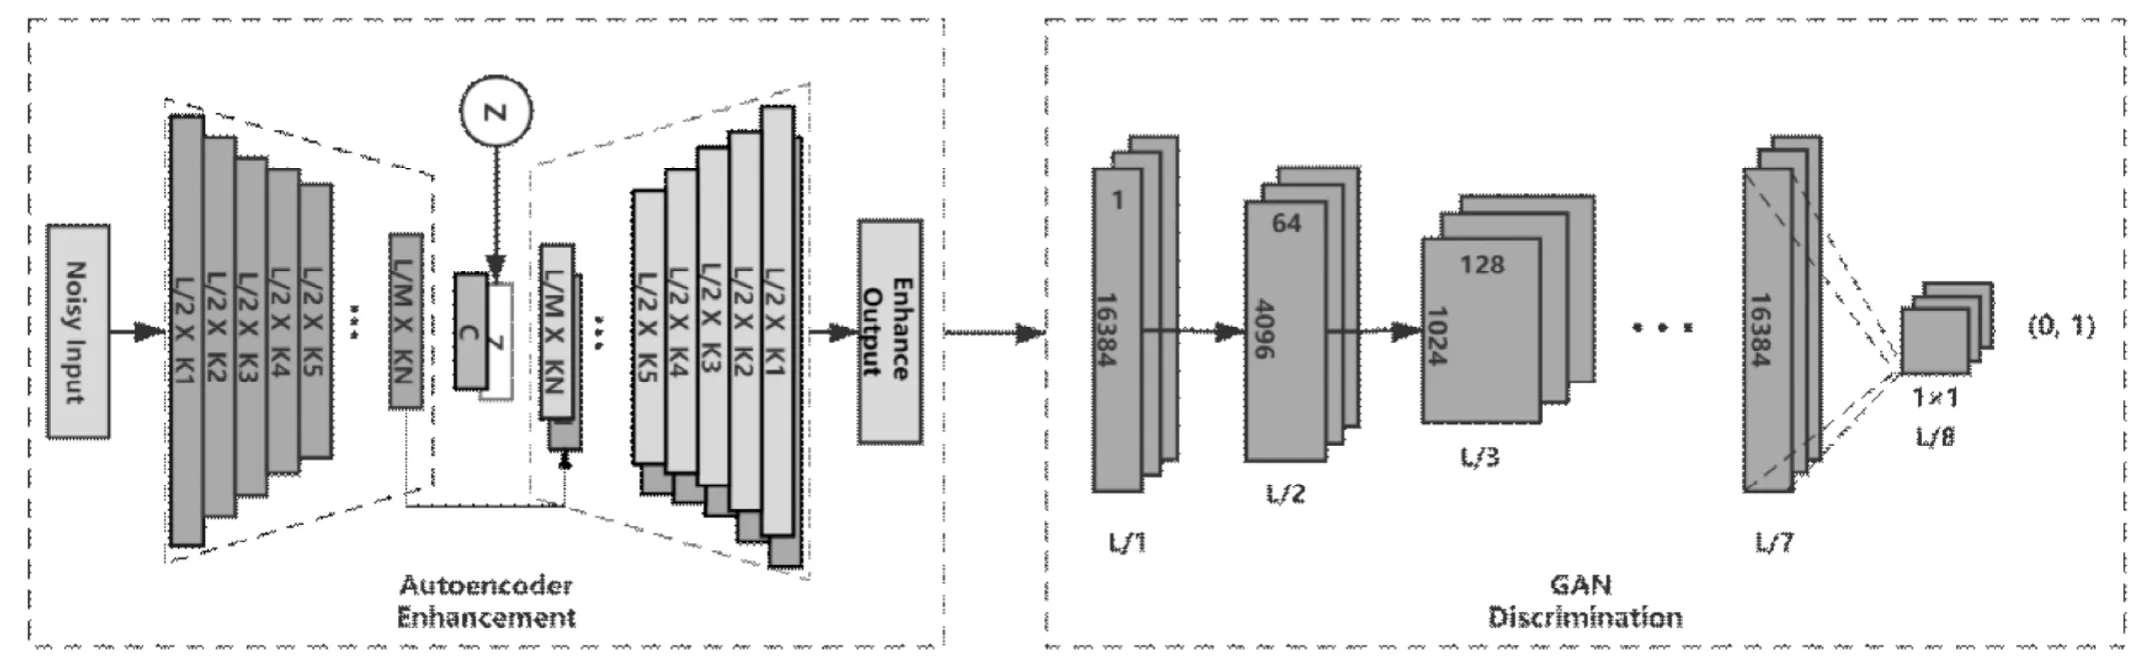
图1 多损失函数结构Fig.1 Multi-loss function structure
1 多损失函数
使用对抗网络判别器作为损失函数,判别器网络被链接在基于自编码器的语音增强网络后。……
登录APP查看全文