绝对值函数的一类新的光滑近似
2021-03-04王俊
王 俊
(江苏科技大学 理学院, 镇江 212100)
在最优化领域中,非光滑优化问题[1]越来越引起研究者的重视.主要是因为这些不可微的目标函数有一些实际的意义或者好的特性.比如,比较活跃的压缩感知领域中的lp(0 首先,给出连续不可微函数的光滑近似的定义,而连续可微函数又称为光滑函数. 另外,对于任意的t∈R,两类连续不可微函数绝对值函数|t|和最大值函数max{0,t}的等式关系: |t|=max{0,t}+max{0,-t} (1) 由式(1)说明这两类连续不可微函数是可以相互转化的.另外,需要特别指出的是,虽然最大值函数max{0,t}是连续不可微的,但是max2{0,t}是连续可微的,且其导函数为2max{0,t}. 文献[6,10,12-13]基于卷积的性质,利用分段连续的密度函数ρ:R→R+构造最大值函数的单参数光滑近似.需要注意的是,这个密度函数满足: (1) (对称性)ρ(s)=ρ(-s) (2) (有界性)有界常数 利用密度函数的两个性质,可以验证 是定义好的(well-defined).另外,对于任意给定的参数μ>0,φ(t,μ)关于变量t是连续可微的、凸的和严格递增的,而且还满足: 0≤|φ(t,μ)-max{0,t}|≤κμ 由不等式和定义1可得φ(t,μ)是max{0,t}的光滑近似,并且称这个常数κ为光滑近似的有界常数.显然,构造不同的密度函数可得不同的光滑近似函数. (i) 取 那么 称为max{0,t}的光滑近似.再由式(1)有: 是绝对值函数|t|的光滑近似. 称为max{0,t}的光滑神经网络近似.结合式(1)可得: 是绝对值函数|t|的光滑近似.又因为 max{x1,x2}=x1+max{0,x2-x1} 则 是max{x1,x2}的光滑近似.进一步把以上结果推广到n维欧式空间Rn上可得: 是max{x1,x2,…,xn}的一个光滑近似. 称为max{0,t}的CHKS[9]光滑近似.结合式(1)可得: 是绝对值函数|t|的一个光滑……1 光滑近似函数
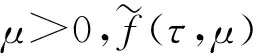
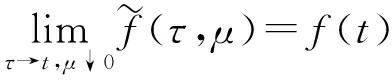
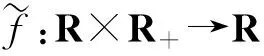
1.1 基于卷积的光滑近似