基于SVM的网络不良信息识别方法
2021-03-04陆向艳,陆生权,刘峻
陆向艳,陆生权,刘峻
摘要:当前用户在互联网中发布的一些文本信息中包含色情、暴力、政治敏感或恶意广告等不良信息,对网络生态环境造成破坏,特别对广大青少年网民的健康成长影响较大。本文提出一种基于SVM的不良信息识别方法,该方法包括文本标记、文本分词、Doc2Vec文本向量化、SVM不良信息分类器训练、SVM不良信息测试5个步骤。实验结果表明该方法能有效识别网络不良信息,为网络不良信息的甄别提供了一种方法参考。
关键词:不良信息 ;SVM;识别;Doc2Vec;Jieba分词
中图分类号:TP391 文献标识码:A
文章编号:1009-3044(2021)34-0097-02
1引言
当前互联网进入了快速发展的阶段,第44次《中国互联网络发展状况统计报告》[1]显示,截至2019年6月,我国网民数量达8.54亿。互联网信息发布呈指数级的快速增长,其中一些信息内容涉及色情、暴力、政治敏感或为恶意广告,这些信息对网络生态环境造成了不良影响,若不加甄别将对广大青少年网民的健康成长带来不利影响。将网络不良过滤后,再呈现给青少年具有重要意义。当前互联网不良信息识别主要有基于语义和基于机器学习两种方法[2-5],基于后者本文提出一种基于SVM的不良信息識别方法,为不良信息识别,净化网络提供参考。
2 基于SVM的网络不良信息识别方法
2.1 识别模型
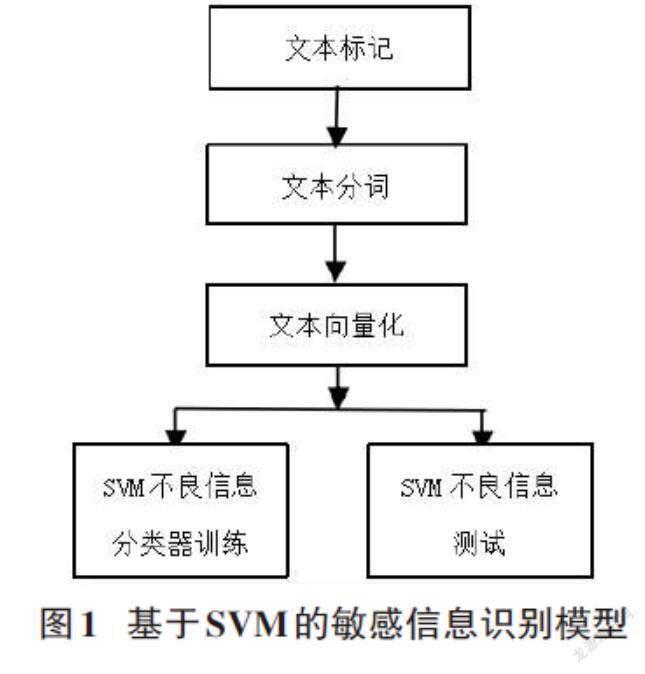
基于SVM的网络不良信息识别方法包括文本标记、文本分词、Doc2Vec文本向量化、SVM不良信息分类器训练、SVM不良信息测试5个步骤,方法模型如图1所示。
2.2文本标记
用爬虫收集网络文本数据集,将数据集分成训练集和测试集两部分,并进行分类标记,不包含色情、暴力、政治不良和广告这四种敏感词的文本数据集标记为正面数据,包含的则标记为负面数据,并按类别分开训练和测试。……
