基于信息熵的适应性随机测试用例生成算法分析
2020-07-09孙德刚
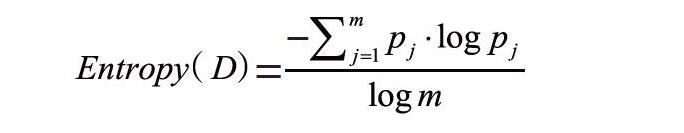
摘 要:文章对适应性随机测试理论基础进行分析,并在信息熵基础上对测试用例算法加以阐述,主要包括信息熵指标、算法应用、实证实验三项内容,通过文章研究可知,Entropy算法与其他算法相比,无论在高维还是低维空间情形下,均具有良好的失效检测能力。
关键词:信息熵;适应性随机测试;算法
中图分类号:TP301.6 文献标识码:A 文章编号:2096-4706(2020)02-0030-02
Abstract:This paper analyzes the theoretical basis of adaptive random testing,and explains the test case algorithm based on information entropy. It mainly includes three items:information entropy index,algorithm application,and empirical experiments. According to the research in this paper,Entropy algorithm and other compared with the algorithm,it has a good failure detection ability in both high-dimensional and low-dimensional space situations.
Keywords:information entropy;adaptive random test;algorithm
0 引 言
在信息时代背景下,计算机软件在技术产业得到广泛应用,对软件质量与可靠性提出严格要求,软件测试的地位不断提升。在软件测试过程中,测试用例选择十分重要,对测试效果具有直接影响。对此,应尽量采用典型用例,在信息熵的基础上采用适应性测试用例,引入FSCS-ART经典算法,提高揭错能力。
1 适应性随机测试的理论基础
1.1 随机测试
在软件测试方面,随机测试的应用范围较为广泛,测试时无需掌握程序中的内部结构与软件需求,只需在输入空间内部采用伪随机数生成器,便可对数据点进行自动化测试,具有成本低、自动化程度高、实施简便等特点。现阶段,软件种类不断增加,Unix工具集、Java程序、Windows GUI应用软件等在测试活动中得到普遍应用,还可与其他软件测试方法综合使用,如组合测试、回归测试等等。随机测试具有预测性,通过统计意义可对其检测能力进行分析,在此基础上的改进算法也随之产生。
1.2 FSCS-ART算法
在随机测试中,该方法属于第一个具体算法,受到软件工程领域的广泛关注。该算法适用于输入值为数值型的待测程序,利用用例候选策略,将候选用例与已测用例为标准,对多样性进行判断。……