融合用户相似度与信任度的协同过滤推荐算法
2017-07-12蒋宗礼李慧
软件导刊 2017年6期
蒋宗礼+李慧

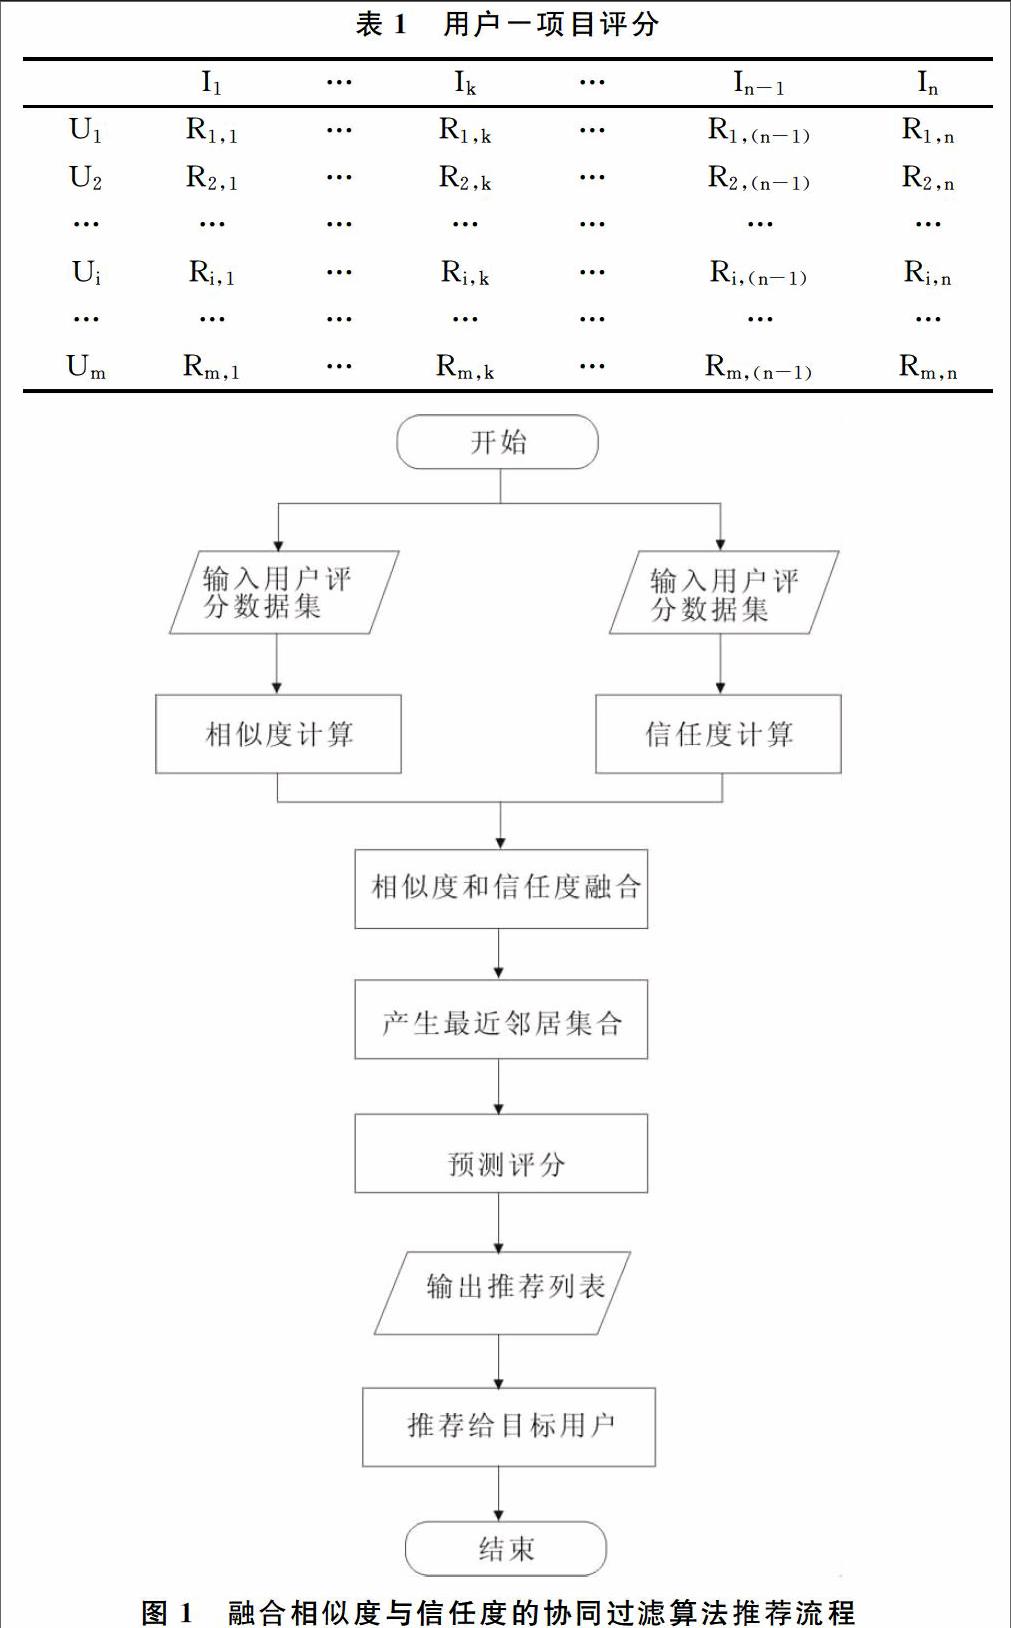
摘要:传统的协同过滤算法难以解决“稀疏性”和“冷启动”等问题。鉴于此,提出一种融合用户相似度和信任度的方法。首先根据用户对共同项目的评分创建初始信任度,通过信任关系的传递规则,建立没有直接信任关系的用户之间的信任关系,然后融合用户相似度与信任度,用于传统的协同过滤推荐系统,找出用户的最近邻居集,进行项目的评分预测,从而产生推荐列表。实验表明,改进后的算法能有效提高系统推荐的准确性。
关键词:协同过滤;推荐系统;信任度;用户相似度
DOIDOI:10.11907/rjdk.162798
中图分类号:TP312
文献标识码:A 文章编号:1672-7800(2017)006-0028-04
0 引言
随着互联网的迅猛发展,信息过载问题越发严重。为了缓解该问题,在海量信息中找到真正所需的信息,Goldberg等[1]在1992年首次提出了协同过滤推荐算法。该算法利用用户对项目的评分记录,计算与目标用户有着相似兴趣爱好的最近邻居用户集,并根据该邻居集对目标项目的评分情况,计算目标用户对目标项目的预测评分值,最终把N个最高预测评分值的项目推荐给目标用户。协同过滤推荐算法简单高效,已经成为目前最流行的个性化推荐算法之一。然而,随着系统规模的扩大,协同过滤算法会出现数据稀疏性(Data Sparsity)、冷启动(Cold Start)、可扩展性等问题,使得协同过滤算法容易受到这些问题的困扰[2]。
针对稀疏性问题,Sarwar等[3]提出使用矩阵奇异值分解的方法对评分矩阵进行降维以减少稀疏性。邓爱林等[4]提出首先根据基于项目的协同过滤算法预测部分项目评分,减少评分稀疏性,再根据基于用户的协同过滤算法为用户推荐。……
登录APP查看全文
