MMSEG算法与统计方法结合的中文分词模型研究
2017-07-02
岭南学术研究 2017年1期
(东莞理工学院城市学院,广东 东莞 523419)
在信息检索和数据分析等领域存在大量的中文文本数据,而使用计算机对这些数据进行处理之前都必须进行分词的处理。分词需要高效、准确的算法。目前常见的分词模型有基于机械式的字符串匹配、基于字符串的统计频率、基于自然语言语法语义的理解等。其中基于规则的分词方法如最大匹配法(MM)及其各种变体,因为规则覆盖率不高和规则的主观性较强,准确率有所不足[1]。常见的基于统计的模型如N-gram、隐马尔可夫模型(HMM)、最大熵马尔可夫模型(MEMM)和条件随机场(CRF)等分词方法过于依赖训练语料库,分词效率较低,同时在分词过程中忽视了汉语的句法、语法等信息[2]。结合规则与统计的方法是中文分词领域研究的热点。本文结合规则和统计分词算法提出一种改进的分词模型,该模型将最大匹配算法的一个变体——MMSEG算法[3-4]与统计方法相结合,根据中文分词中所遇到的问题,对模型进行逐步优化,最终实现分词方法的时间复杂度降低,以及分词的召回率(recall)和F-measure指标的提高。
一、分词算法及其实现
(一)MMSEG分词算法
MMSEG包含简单最大匹配法和复杂最大匹配法,本文选取其中的复杂最大匹配法与统计方法进行结合。MMSEG的复杂最大匹配法首先识别出从当前读取位置开始所有的块(chunk),块是包含三个词的组合。对于句子 由多个字符构成,则
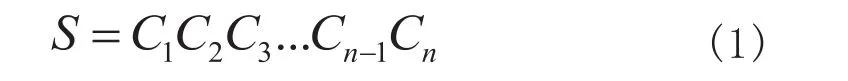
当前分词位置为 时则其所有块组成的集合表达式为
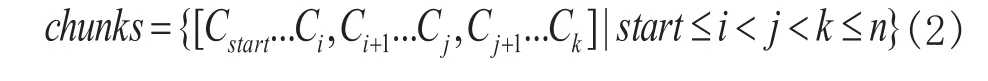
例如有字典dict=[研究,生命,研究生],对句子“研究生命”进行分词则能分出所有的块:[研究,生命],[研究,生,命],[研究生,命],[研,究,生命],[研,究,生]。……
登录APP查看全文