文本挖掘在基因组注释中的应用
2017-03-21,
,
基因组注释是指利用生物信息学方法对基因组中所有基因的生物学功能进行高通量注释,包括核苷酸级别的注释、蛋白质级别的注释以及流程级别的注释[1]。目前,常规的基因组注释方法存在步骤过于繁琐、需要借助高精尖设备、人工操作存在误差、 “同源-功能相似”只是一种假说、模体本身具有的层次性以及涉及的分析工具较多无法自动化操作等问题,得到的结果存在误差[2]。随着计算机技术的发展以及关于基因研究的生物医学文献数量的不断增加,利用文本挖掘技术[3]对生物医学文献分析来实现对基因组注释成为一种新的研究趋势。
1 材料和方法
笔者利用WOS数据库中的文献作为研究的样本来源,检索策略为:TS=(gene annotation* OR genomic* annotation*) AND TS=(text mining OR literature mining),检索时间为2016年10月19日,限定时间段在2000-2016年之间,得到328篇相关文献。利用书目共现分析软件BICOMB抽取相关文献中的引文,选取出现频次在15次及以上的引文,共得到16篇高被引论文(表1)。利用BICOMB构建高被引论文——来源文献矩阵(该矩阵可反映高被引论文在来源文献中的分布情况),然后将词篇矩阵导入聚类分析软件gCluto中进行高被引论文的同被引聚类分析。
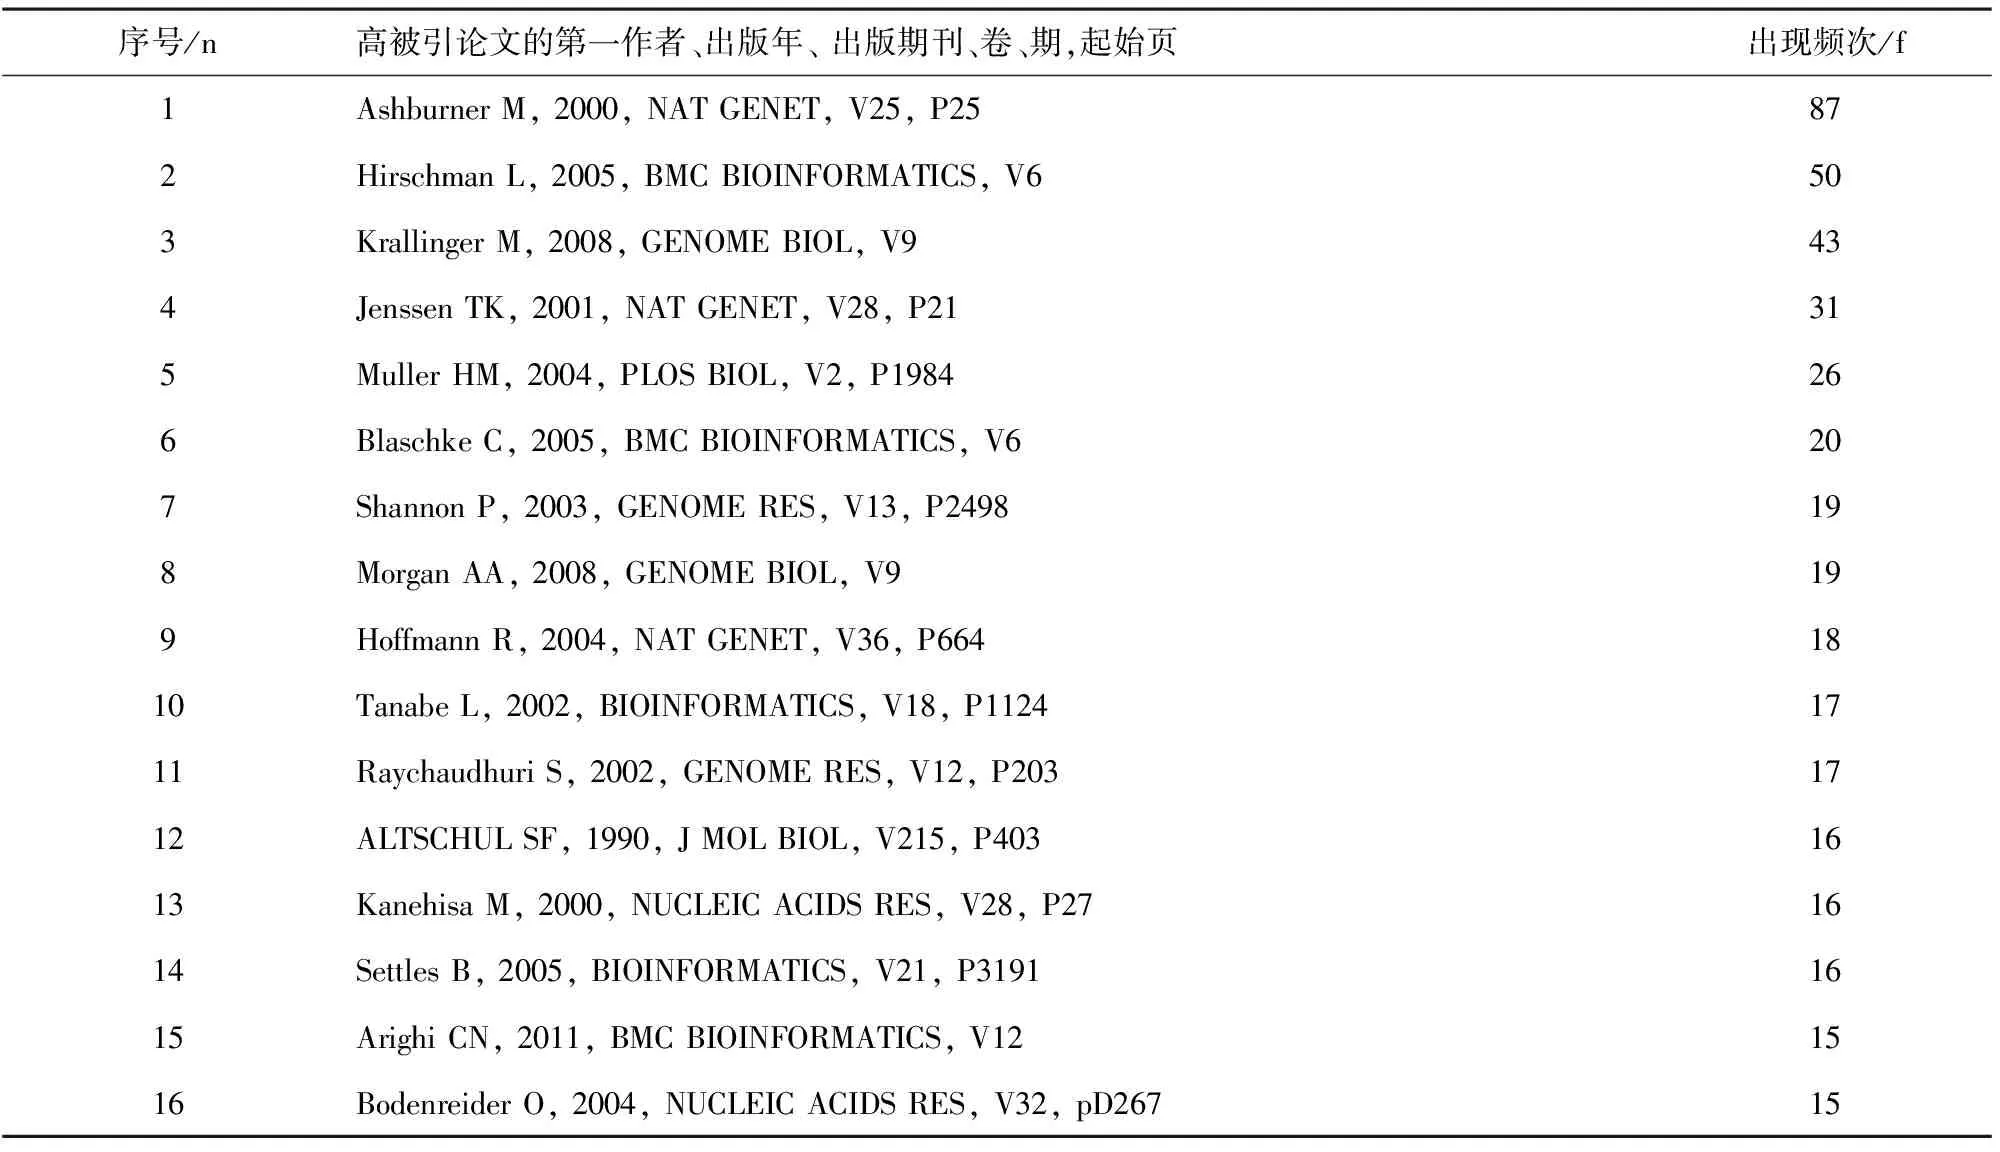
表1 328篇来源文献中的高被引论文(n=16,f>=15)
2 结果与分析
将同被引聚类分析结果用可视化图像表示,山峰图见图1,棋盘图见图2。图1中16篇高被引论文根据其在328篇来源文献中的被引情况可分成3个大类;图2中行聚类是对于高被引论文的聚类,列聚类是对于来源文献的聚类。图2中行聚类结果也表明该16篇高被引论文可分为3类,表示文本挖掘技术在基因组注释中的3个应用方向。各……
