基于编辑距离的无序词表的对齐和定位
2016-09-26赵志靖
赵志靖
摘要:语言调查采集到的数据存在相当程度的差异,需要进行二次加工。本文基于编辑距离算法实现从语言和方言词汇大数据中的词汇相似匹配及数据的对齐和定位。通过对达让语数据进行的三次实验发现,在做距离计算时,以词算而不是以词加括号内注释的整体去算的方式在保证抽取词汇召回率的基础上准确率会显著提升。实验结果表明,基于编辑距离的数据抽取方法是可行的,具有较好的检索效果。
关键词:编辑距离;相似度
中图分类号:TP391 文献标识码:A
Abstract: The data of languages collected from field research have considerable differences,they need for secondary process.This paper implements the match and extraction of vocabulary similarity from the big data of language and dialect vocabulary based on levenshtein distance algorithm.Through the three experiments made by using the data of Darang, the research finds that the way of counting words rather than words and comments in brackets as a whole increases the precision rate dramatically on the basis of ensuring extraction vocabulary recall rate when the levenshtein distances are computed. The experimental results show that it is feasible to extract data based on levenshtein distance, the aboved method has better retrieval effect.
Keywords: Levenshtein Distance;similarity
引言
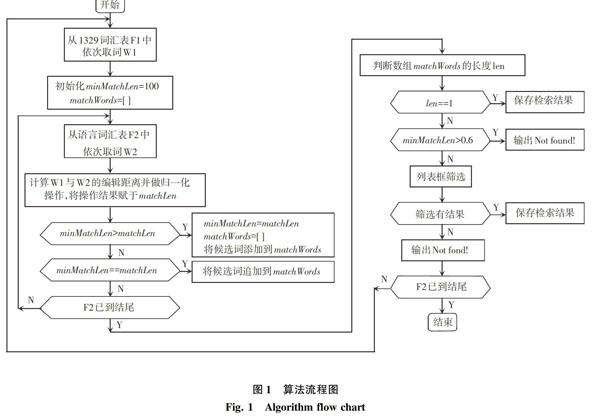
中国语言研究中,经历了60余年大规模数据的采集,形成约数千种语言和方言词汇大数据。不过这些数据因调查理念、调查目的、调查方式、调查领域、调查词表等不同而存在不同程度的差异,需要进行二次加工处理,这批宝贵资源对语言工程和语言文化建设具有重要价值。本文目标提出对采集的语言数据二次加工,建设统一格式词表,便于后续的语言科学研究。也就是说语言调查采集到的数据是无序的,且数量不等,本文拟建设统一格式词表,该词表包括1 329个词汇,并且这些词汇是按照顺序排列的,然后又从数千种语言词汇大数据中,每种语言都抽取意义相同1 329个词汇,如果没有找到,则以空表示,这就涉及到数据的定位,由于这1 329个词汇是按照顺序排列的,所以还涉及到数据的对齐,最后将每种语言按顺序排好的1 329个词汇保存为独立的Excel文件,供语言分析研究使用。……