文本挖掘的方法及应用研究
2011-08-08张晓艳华英
电脑与电信 2011年12期
张晓艳 华英
(苏州市职业大学计算机工程系,江苏 苏州 215104)
1.引 言
传统的数据挖掘主要针对结构化的数据,如关系的、事务的和数据仓库数据。但随着互联网应用的兴起和普及,涌现出巨量的电子信息,如电子文档、电子出版物、万维网等,其中以文本形式的信息占比最大。这些文本信息存储在文本数据库中,属于半结构化数据。文档挖掘技术可帮助用户比较非结构化的文本信息,确定文档的重要性和相关度,找出多个文档的共通模式或趋势,成为数据挖掘中的一个重要研究方向。
2.文本挖掘的处理过程
文本挖掘从数据挖掘发展而来,但面向的是半结构化或非结构化的文本数据,无确定形式并且缺乏机器可理解的语义;因此除采用数据挖掘的一些常见方法之外,还涉及到文本分析、模式识别、统计学、数据可视化、数据库、机器学习等技术的运用。
文本挖掘的处理过程主要包括对含有大量文档集合的内容进行文本预处理、特征提取、结构分析、文本摘要、文本分类、文本聚类、关联分析、质量评估、模式生成、结果输出等,如图1所示。
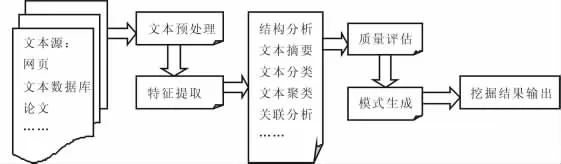
图1 文本挖掘的处理过程
文本预处理的目的是选取任务相关的文本并将其转化成文本挖掘工具可以处理的中间形式。特征提取一般会构造一个评价函数,对每个特征进行评估,按分值高低排列,预定数目分数最高的特征被选取。接着将进行一系列分析挖掘步骤,利用机器学习、数据挖掘以及模式识别等方法提取面向特定应用目标的知识或模式。……
登录APP查看全文