融入句法结构和摘要信息的文本蕴含识别模型
2023-10-21钟茂生罗贤增王明文
计算机技术与发展 2023年10期
钟茂生,孙 磊,罗贤增,王明文
(江西师范大学 计算机信息工程学院,江西 南昌 330200)
0 引 言
文本蕴含(Recognizing Textual Entailment,RTE)定义为一对文本之间的有向推理关系,其中前提句记作P(Premise),假设句记作H(Hypothetical)。如果人们依据自己的常识认为H的语义能够由P的语义推理得出的话,那么称P蕴含H,记作P→H[1]。文本蕴含识别任务的目的是判断这两个文本之间的语义关系:蕴含(Entailment)、矛盾(Contradiction)、中立(Neutral)。从另一个角度来看,这是融合语义关系的三分类问题,具体示例如表1所示。
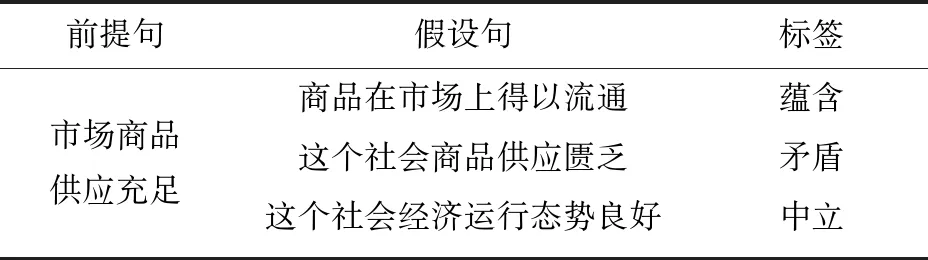
表1 数据示例
近些年来,随着深度学习的快速发展,以及大规模数据集的发布,越来越多的研究者开始将深度神经网络应用于文本蕴含关系识别任务中[2-4],并在一些数据集上取得了巨大的提升。在深度学习的方法中,许多研究者都采用长短期记忆网络(Long Short-Term Memory,LSTM)对句子进行建模,分别得到两个句子的句向量表征,再通过互注意力机制学习两个文本之间的交互信息,最后通过分类器判定两个句子之间的语义关系[5-7],当前的大多数研究也都是基于句向量表征和互注意力机制的方法。虽然这些方法相比之前的传统方法有着巨大的提升,但是仍面临一些问题需要解决:
(1)互注意力机制的方法只能捕获局部交互信息。仅考虑局部交互信息,易弱化句子的整体信息。
(2)未考虑句子的句法信息。大多数方法都注重句子之间的信息交互,忽略了句子的句法结构信息。
针对上述问题,该文提出了融合句法结构和摘要信息的文本蕴含识别模型,并将文本蕴含识别的思想应用于公务员试题中,主要贡献如下:
登录APP查看全文