基于K- Means 聚类算法的数据分析
2021-08-23邵小青贾钰峰章蓬伟
邵小青 贾钰峰 章蓬伟 丁 娟
(新疆科技学院信息科学与工程学院,新疆 库尔勒 841000)
1 概述
机器学习中有两类大问题:一个是聚类,另一个是分类。聚类是统计学的概念,属于非监督机器学习(unsupervised learning),应用中数据挖掘,数据分析等领域,根据数据不同特征,将其划分为不同的数据类,属于一种无监督学习方法。它的目的是使得属于同一类别个体之间的密度尽可能的高,而不同类别个体间的密度尽可能的低[1]。分类是用已知的结果类别训练数据,对预测数据进行预测分类,属于有监督学习(supervised learning),常见的算法如逻辑回归、支持向量机、深度学习等。聚类也是对数据进行归类,不过聚类算法的训练数据只有输入,事先并不清楚数据的类别,通过特征的相似性对文本进行无监督的学习分类。聚类试图将数据集中的样本划分为若干个通常不相交的子集,每个子集称为一个簇(cluster)[2]。K-means 属于经典聚类算法,根据样本间的距离或者相异性进行聚类,把特征相似的样本归为一类,相异的样本归为不同的簇。
2 理论基础
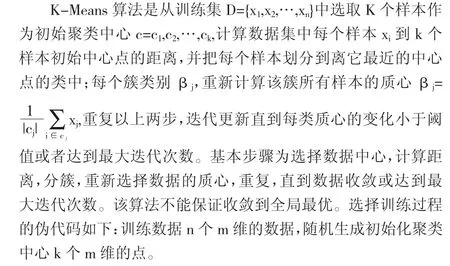
While(t) t 为迭代次数
For i in range(n+1): #n 为样本点个数。
For j in range(k+1): #k 为簇的数目。
For i in range(k+1): #计算样本i 到每个簇质点j 的距离。
找出属于这个簇中的所有数据点,计算这类的质心。重复以上步骤,直到每类质心变化小于设定的阈值或者达到最大的迭代次数。设置最大特征数,设置分类的组K 值,训练特征数据进行数据分析。
本文将数据过滤清洗,去除停用词转化为向量模型,使用TF-IDF 算法对词频进行权重计算,TF 是词频,IDF 是逆文档频率,TF-IDF 反应了一个词在文本中的重要性它的值是TF×IDF。……