用于表格事实检测的图神经网络模型∗
2021-05-23邓哲也
软件学报 2021年3期
邓哲也,张 铭
(北京大学 信息科学技术学院 计算机科学技术系,北京 100871)
随着如今文本数据越来越多,并且可以轻松地通过互联网传播,当人们面对错综复杂的信息时,为了辨别信息的真假,需要对这些信息进行验证,这就体现出了事实检测任务的重要性.
在自然语言理解和语义表征的研究中,验证一句文本陈述是否基于给定的事实证据非常重要,这是自然语言理解中的一个基础任务.现有的研究主要局限于处理非结构化证据的事实验证,如自然语言的句子、文档、新闻等,在这一类研究中,细分下来有很多不同的任务,如检查文本关联性[1]、自然语言推理[2]、基于维基百科的事实验证[3].它们用到的证据都是纯文本信息.而结构化证据下的验证还有待探索,比如基于表格、图表、数据库等形式的事实验证.在这一类研究中,有基于图片证据的数据集NLVR[4]/NLVR2[5],还有基于表格证据的数据集TabFact[6].
TabFact 数据集是一个包含1.6 万个维基百科中的表格作为事实证据和11.8 万条人工标注的自然语言陈述的事实验证数据集.不仅形式上与纯文本数据不同,采用的是表格形式的数据,而且它与一般的事实验证数据集不同的点在于,它要求模型同时具有语义推理和符号推理的能力.图1 就是该数据集的一个实例.
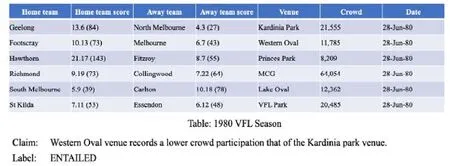
Fig.1 An instance of the TabFact dataset图1 TabFact 数据集的一个实例
TabFact[6]中提出了两个基线模型,分别是基于自然语言推理的Table-BERT 和基于搜索和数据库查询的LatentProgram 算法.这两个做法都没有取得非常好的效果,因……
登录APP查看全文