捕获局部语义结构和实例辨别的无监督哈希∗
2021-05-23李长升闵齐星成雨蓉王国仁
软件学报 2021年3期
李长升,闵齐星,成雨蓉,袁 野,王国仁
1(北京理工大学 计算机学院,北京 100081)
2(电子科技大学 计算机科学与工程学院,四川 成都 611731)
随着互联网的快速发展以及数据(例如图片、视频、文档等)的爆炸式增长,如何快速地检索到用户需要的信息,已经成为学术界和工业界研究的热点问题之一.作为已经被公认为是一种非常高效地用于大规模信息检索的手段之一,哈希技术近年来得到了突飞猛进的发展.从原理上来讲,哈希方法通常将高维连续空间的数据(例如图像、视频、文本等)映射到一个低维的二进制空间中(也就是,哈希空间),如图1 所示.在映射的过程中,期望在哈希空间中能够保持原始空间的信息.由于使用二进制编码对数据进行特征表示,哈希方法可以极大地减少存储代价以及计算复杂度,并因此可以快速地对大规模数据集进行检索查询.因此,哈希方法可以被视为一种支持大规模数据检索的高效特征学习的新技术.由于其具有广泛的潜力,目前为止,哈希方法已经被广泛地应用于各种各样的任务中,包括跨媒体检索[1]、推荐系统[2]、复制检测[3]等.
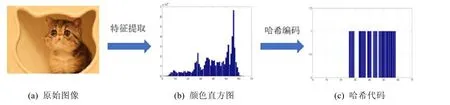
Fig.1 Brief introduction of Hashing图1 哈希过程的简单介绍
早先的哈希方法大部分是不依赖于数据的,例如,经典的局部敏感哈希(locality sensitive Hashing,简称LSH)[4]试图通过随机映射的方式产生嵌入表示.这类技术的一个优势是在极限情况下,随着哈希编码位数的增加,随机映射可以保持输入间的距离.由于这类方法产生哈希函数不依赖于……
登录APP查看全文