基于Python的网络爬虫与反爬虫技术的研究
2021-03-16江西科技师范大学张宝刚
电子世界 2021年4期
江西科技师范大学 张宝刚
随着互联网的快速发展,网络中的信息量也变得越来越巨大。如何从庞大的互联网中快速准确的收集到我们需要的信息,成为了一个巨大的挑战。因此,网络爬虫技术应运而生,相比较于传统的人工搜集,网络爬虫可以快速的持续的准确的搜集到我们需要的信息。但对于网站内容提供者而言,并不希望自己的数据信息被别人搜集到,且爬虫程序的大量请求,也会对服务器造成一定的压力,因此就出现了反爬虫技术。本文将通过一个案例系统的介绍网络爬虫的原理,并指出一些有效的反爬虫技术。
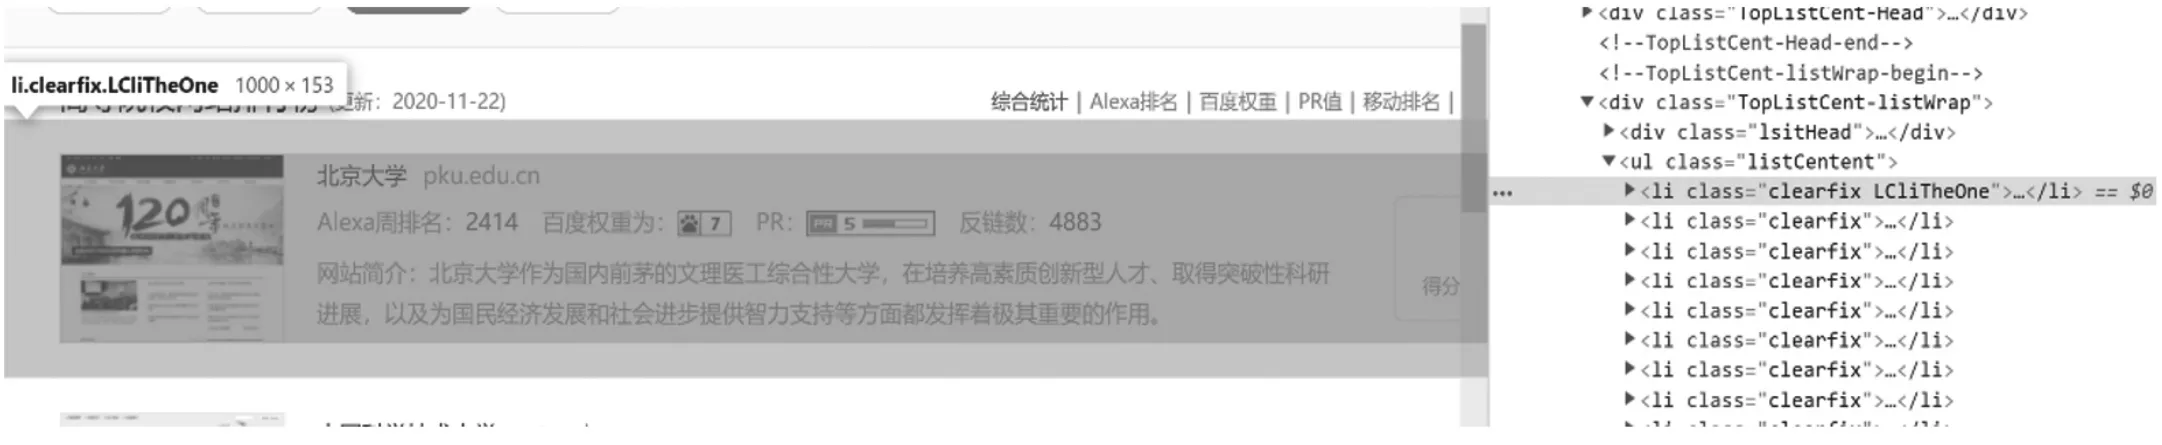
图1 目标网页源码分析
互联网中蕴含着大量的信息,如何有效的获取这些信息并利用这些庞大的信息就变成了一个不小的挑战。传统的人工收集信息的方式效率低、易出错,因此就出现了网络爬虫程序,它是一种根据事先制定好的规则主动的搜集万维网中的数据的一种程序。我们上网用的搜索引擎采用的就是爬虫技术,用无数个爬虫每天爬取各种各样的网站,并把这些网站放到数据库中,等着我们去搜索。网络爬虫根据其实现架构大致可分为深层网络爬虫(Deep Web Crawler)、通用网络爬虫(General Purpose Web Crawler)、聚焦网络爬虫(Focused Web Crawler)、增量式网络爬虫(Incremental Web Crawler)等。本研究主要通过爬取全国高校官网排名情况来介绍爬虫技术的使用,并介绍一些有效的反爬虫技术。
1 爬虫程序的开发
1.1 请求网络数据
开发爬虫程序的第一步是请求网络数据,首先我们要找到要爬取数据的目标网页的url地址,然后利用Requests请求,获取目标html页面的源码。……
登录APP查看全文