文本情绪分析中词嵌入模型对比研究
2021-03-07胡琼李奇王树军
电脑知识与技术 2021年36期
胡琼 李奇 王树军

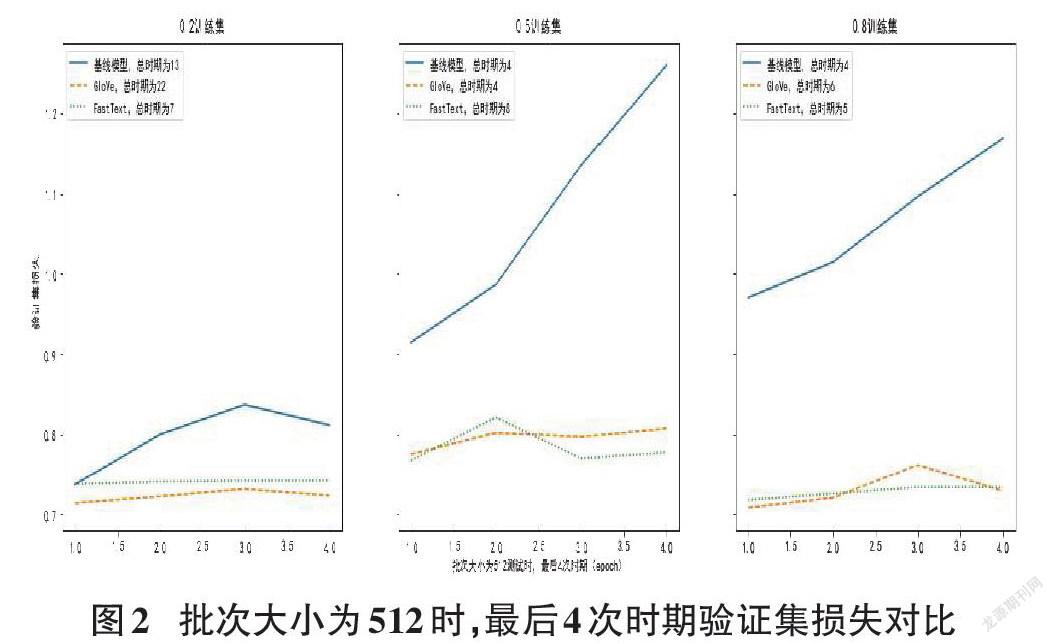
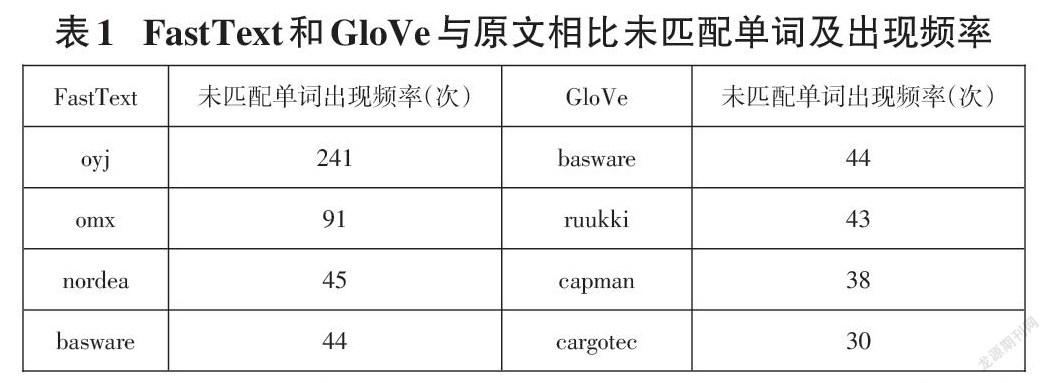
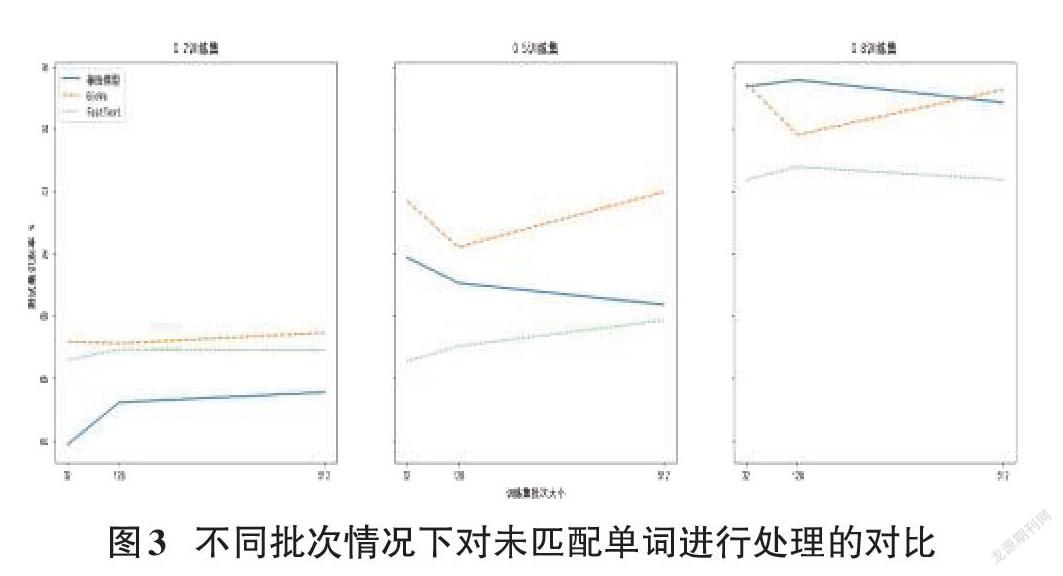
摘要:在利用神经网络进行文本情绪分析时,不同的词嵌入会得到不同的判断结果。该文对比了由文本自身建立的基线模型和预训练词嵌入模型GloVe以及FastText的识别效果,通过实验得出了在不同情况下两种类型的识别优劣性。此外,针对两种预训练词嵌入,得出高频词汇的缺失对总体结果无重要影响的结论。
关键词:情绪分析;预训练词嵌入
中图分类号:TP311 文献标识码:A
文章编号:1009-3044(2021)36-0109-03
开放科学(资源服务)标识码(OSID):
文本情绪分析是在神经网络,尤其是以RNN(Recurrent Neural Network)为方向的深度学习方法上所重点研究的对象之一。简单的文本情绪分类有正、负情感评价之分,稍微复杂一点的增加了中性评价,再为复杂的分类则是以1~5或1~10类似的多级评分表示,如对网店商品的打分,对酒店、旅游景点的评价等。研究文本情绪分析可在一定程度上协助被评价方更改产品体验,改进广告投放策略等。例如KFC决定用在社交媒体上获取的“流行文化元素”作为某一季的产品主题,Apple公司以市场调研和竞争对手产品分析获取的情感评价作为新产品的研发关键词等[1]。
在以文本为分析对象的神经网络结构中,文本信息通常是以词元(token)的形式进行计算,即将单个字符(charlevel)或单词(wordlevel)的数据转换为数字,再将数字转换为固定大小的向量。向量可以由文本自身决定,也可由外部预训练词向量导入。这一将独立的文本信息映射为向量或矩阵的形式称为词嵌入。词嵌入将作为深度模型中嵌入层的输入进行下一步的运算。……
登录APP查看全文
