基于RoBERTa-WWM的中文电子病历命名实体识别
2021-02-27朱岩,张利,王煜
朱 岩,张 利,王 煜
(1.蚌埠医学院护理学院,安徽 蚌埠 233030; 2.中国科学技术大学科学岛分院,安徽 合肥 230001)
0 引 言
随着“互联网+”医疗体系的兴起,产生了大量的电子病历。这些非结构化的文本中包含着关于患者诊疗过程的关键信息,例如临床症状、诊断结果和用药表现[1]。从电子病历(Electronic Medical Records, EMR)中抽取这些医学信息可以更好地帮助研究人员理解某类疾病的病因、病理表现和治疗手段。此外,研究人员还可以利用所抽取的信息构建医疗决策支持系统(Decision Support System, DSS)[2]或医学知识图谱(Knowledge Graph, KG)[3]。然而,从电子病历中手动抽取这些信息是耗时费力的,因此,人们尝试使用自然语言处理(Natural Language Processing, NLP)技术来解决这一问题。
命名实体识别(Named Entity Recognition, NER)是NLP的一项基本任务,其目的在于从非结构化文本中识别出结构化的命名实体。如图1所示,即为从电子病历中抽取关键信息,并让计算机理解语义知识的关键步骤[4]。早期的命名实体识别方法包括基于规则(Rule-based)的方法和基于字典(Dictionary-based)的方法[5-6]。但是这些方法只能识别预先定义或存储于字典中的实体,缺少泛化性。传统的机器学习方法也被用于命名实体识别,例如隐马尔可夫模型(Hidden Markov Model, HMM)[7]。但是这些方法需要人工选择特征。随着深度学习的兴起,人们也使用深度学习的方法进行命名实体识别任务。其中使用最广泛的是可以捕获序列信息的循环神经网路(Recurrent Neural Network, RNN)以及其变种,如双向长短时记忆(Bidirectional Long Short-Term Memory, BiLSTM)网络[8]。但是深度学习方法的效果仍受限于训练集的质量。
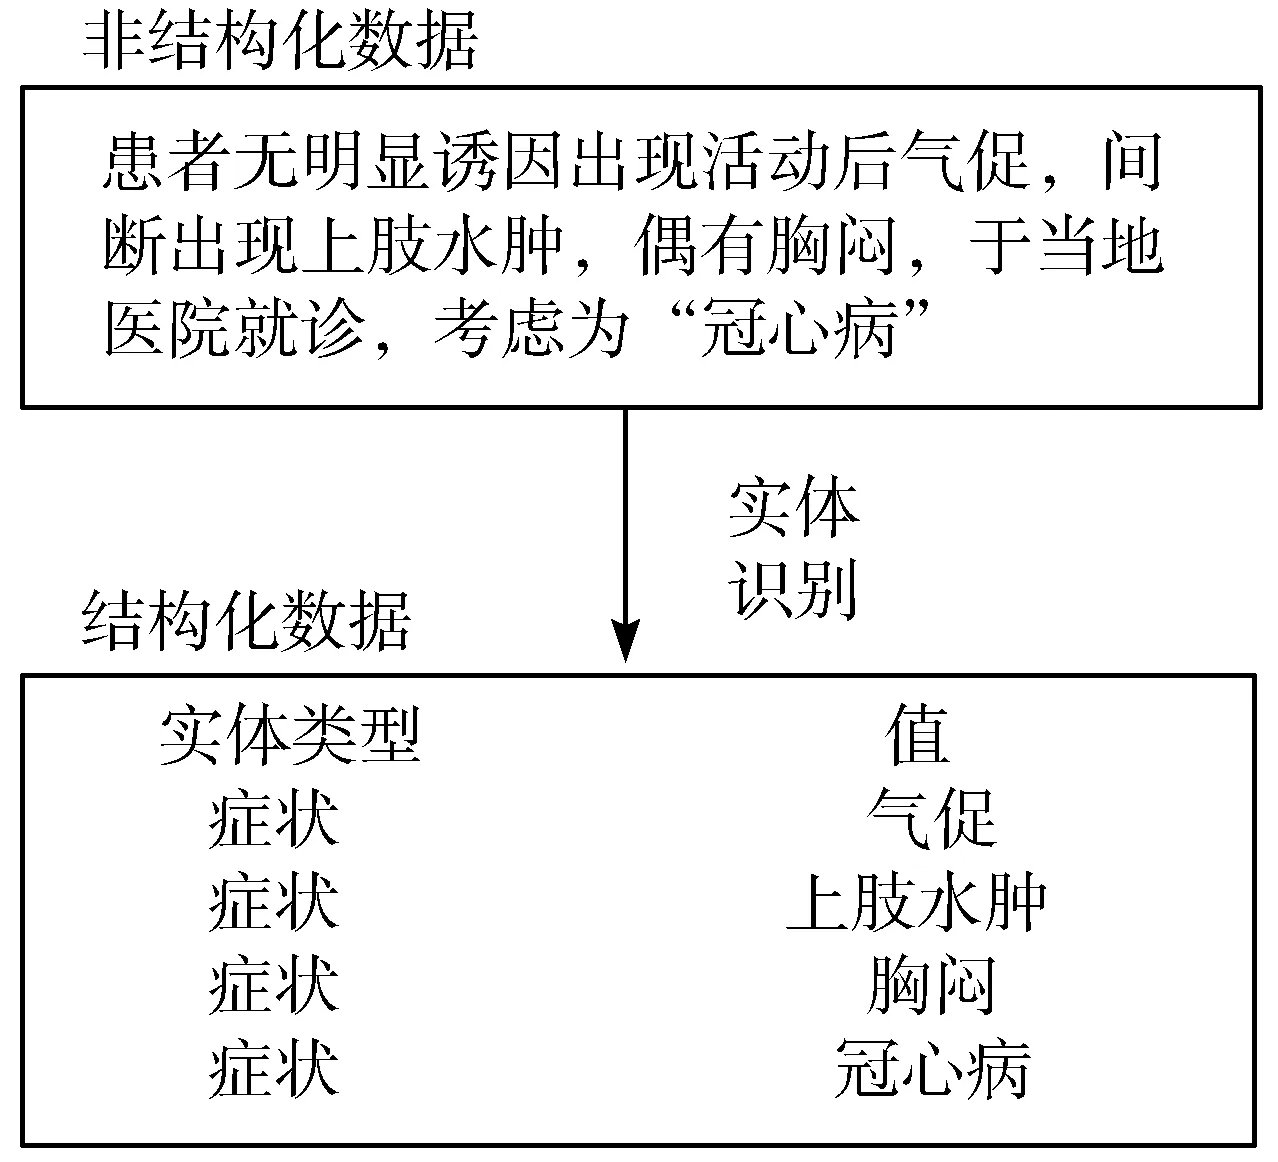
图1 从中文电子病历中识别命名实体……
