强化学习算法与应用综述①
2021-01-21李茹杨彭慧民李仁刚
李茹杨,彭慧民,李仁刚,赵 坤
1(浪潮(北京)电子信息产业有限公司,北京 100085)
2(浪潮集团有限公司 高效能服务器和存储技术国家重点实验室,北京 100085)
3(广东浪潮大数据研究有限公司,广州 510632)
1 引言
近年来,强化学习(Reinforcement Learning,RL)因其强大的探索能力和自主学习能力,已经与监督学习(supervised learning)、无监督学习(unsupervised learning)并称为三大机器学习技术[1].伴随着深度学习的蓬勃发展,功能强大的深度强化学习算法层出不穷,已经广泛应用于游戏对抗[2-4]、机器人控制[5,6]、城市交通[7-9]和商业活动[10-12]等领域,并取得了令人瞩目的成绩.AlphaGo[2]之父David Silver 曾指出,“深度学习+强化学习=通用人工智能(artificial general intelligence)”[13],后续大量的研究成果也表明,强化学习是实现通用人工智能的关键步骤.
1.1 马尔可夫决策过程(MDP)
强化学习的核心是研究智能体(agent) 与环境(enironment)的相互作用,通过不断学习最优策略,作出序列决策并获得最大回报[14].强化学习过程可以描述为如图1所示的马尔可夫决策过程(Markov Decision Process,MDP),其中参数空间可表示为一个五元组〈A,S,P,R,γ〉,包括动作空间(action space)A,状态空间(state space)S、状态转移P:S×S×A→[0,1]、回报(reward)R:S×A→R和折扣因子(discounted factor)γ ∈[0,1].在一些情况下,智能体无法观测到全部的状态空间,这类问题被称为部分观测马尔可夫决策过程(Partially Observed Markov Decision Process,POMDP),在多智能体强化学习(multi-agent RL)设置中尤其常见[15].
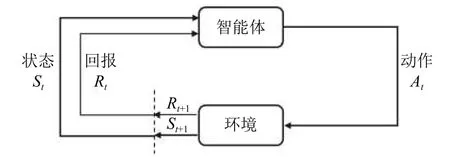
图1 MDP 中智能体与环境的交互作用[14]
具体实施过程中,智能体在时刻t观测到所处环境和自身当前的状态st∈S,根据策略(policy) π,采取一个动作at∈A(S).下一个时刻t+1,环境根据智能体采取的行动给予一个回报rt+1∈R⊂R,并进入一个新的状态st+1,智能体根据获得的回报对策略进行调整,并进入下一个决策过程.MDP 过程中得到的序列为: