基于Python的招聘信息爬虫系统设计
2020-12-23孙亚红
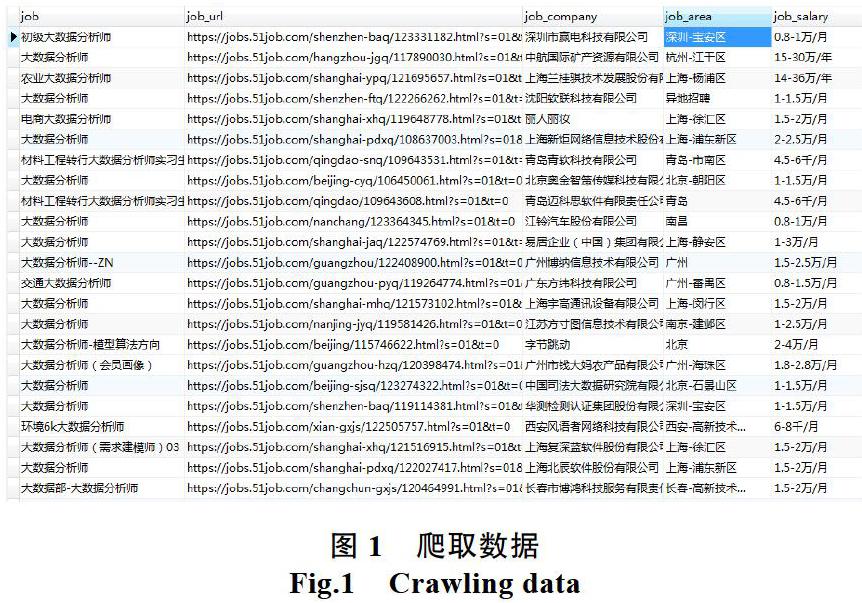
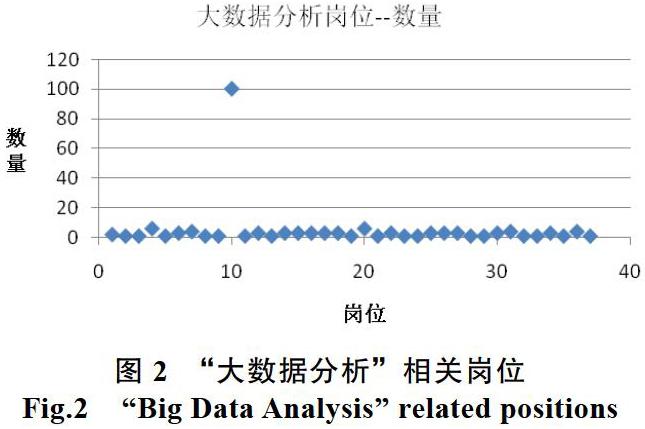
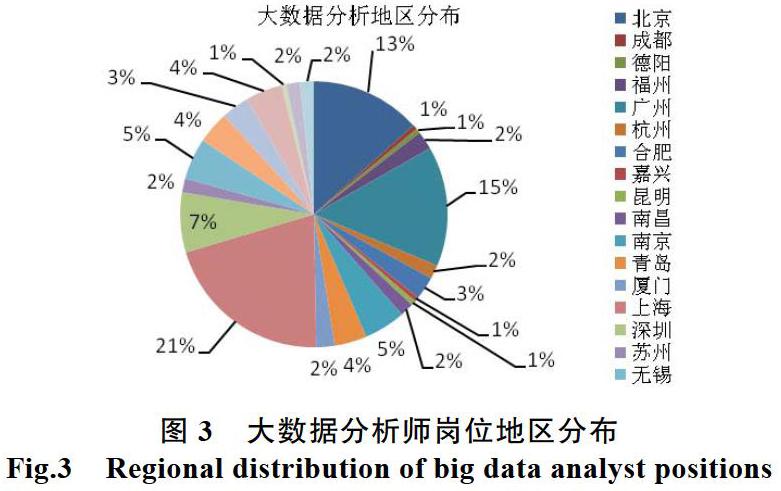
摘 要: 本文詳细阐述了运用Python爬取51job上相关招聘信息的过程,并对所抓取的信息进行处理和分析,按照不同地区,不同薪资把招聘信息以图表的形式进行展示,以期帮助高校毕业生在择业时能够快速获取特定的需求信息,并通过快速数据分析得到自身择业的准确定位,从而做出更好的选择。
关键词: 爬虫;Python;招聘
中图分类号: TP3 文献标识码: A DOI:10.3969/j.issn.1003-6970.2020.10.055
本文著录格式:孙亚红. 基于Python的招聘信息爬虫系统设计[J]. 软件,2020,41(10):213214+235
【Abstract】: This paper describes the process of using Python to crawl the relevant recruitment information on 51job, and processes and analyzes the captured information. According to different regions and different education requirements, the recruitment information is displayed in the form of chart, in order to help college graduates quickly obtain specific demand information when choosing a job, and obtain the accuracy of their own employment through rapid data analysis.
【Key words】: Crawler; Python; Recruitment information
0 引言
伴随着网络信息的爆炸式增长,大数据时代悄然而至。如何在海量的数据当中获取可以有效利用的关键数据信息,成为各界研究的热点[1-5]。网络爬虫是一种按照设计者所设定的规则,模拟成为浏览器,自动驱动抓取网页信息的程序或脚本[6]。利用网络爬虫,设计者可结合自己的目标需求从海量的互联网信息中抓取目标信息数据并存储,为进一步的数据分析,用户画像做好准备。
1 系统设计流程
设计招聘信息爬虫系统的流程如下。
步骤1:分析URL。
步骤2:访问待抓取页面。该模块访问被抓取页面的相关职位信息,利用Requests库下载待抓取页面的html代码。
步骤3:下载,解析,抽取信息。在该模块,使用lxml等Python库解析页面,并根据预先制定的规则,抽取信息。
步骤4:存储。在该模块中,针对不同类型的数据创建mysql表格,把爬取的数据存储在mysql数据库的表格中。
步骤5:分析数据并可视化。
2 系统实现各关键技术
2.1 抓取模块
打开51job,在职位搜索栏中输入“数据分析师”,页面上显示所有关……
