一种受限玻尔兹曼机的词义消歧方法
2019-01-14张春祥李海瑞高雪瑶
张春祥 李海瑞 高雪瑶
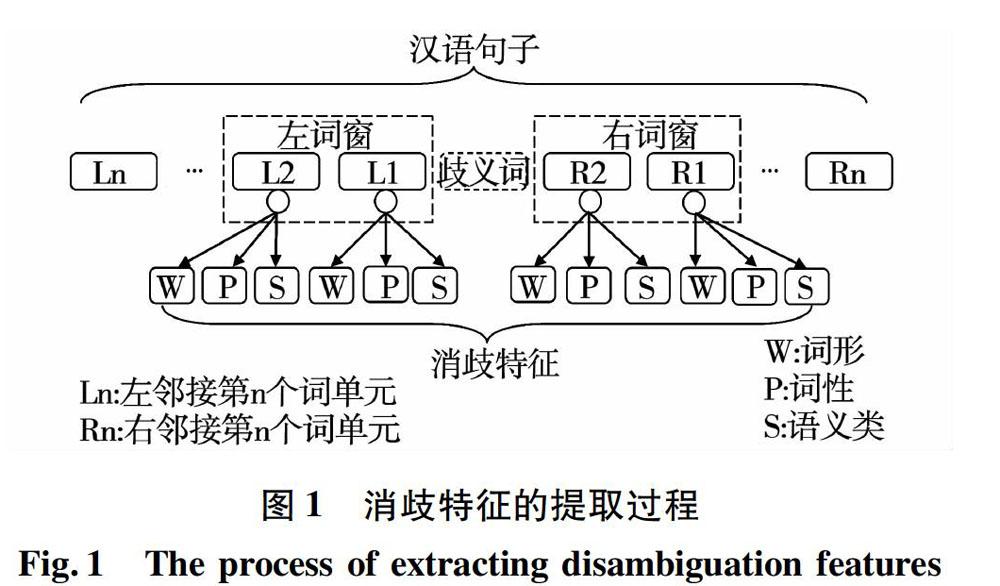
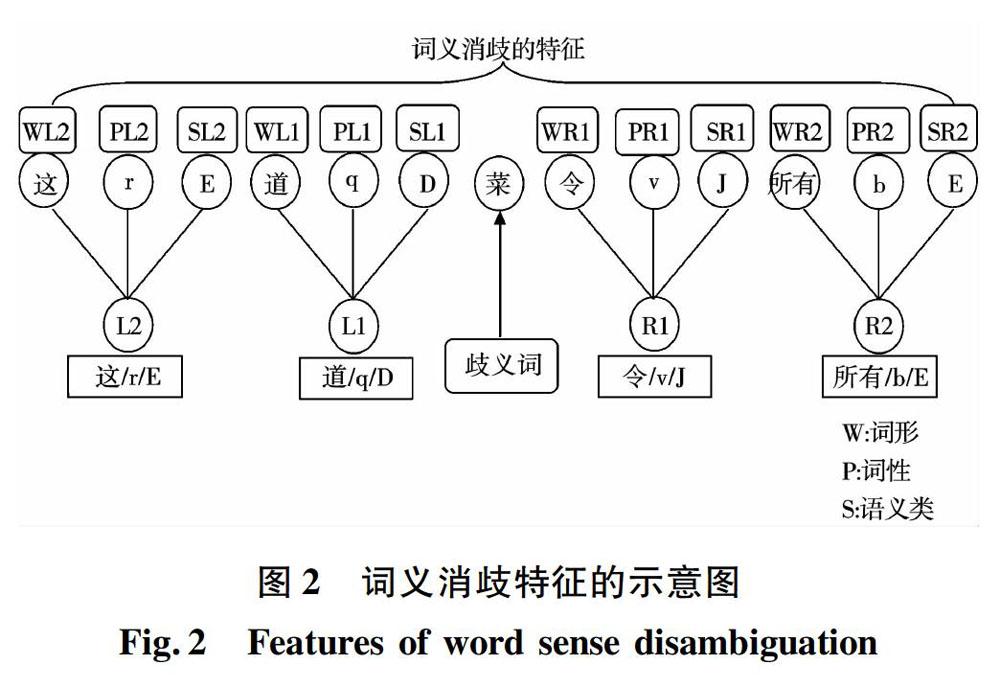
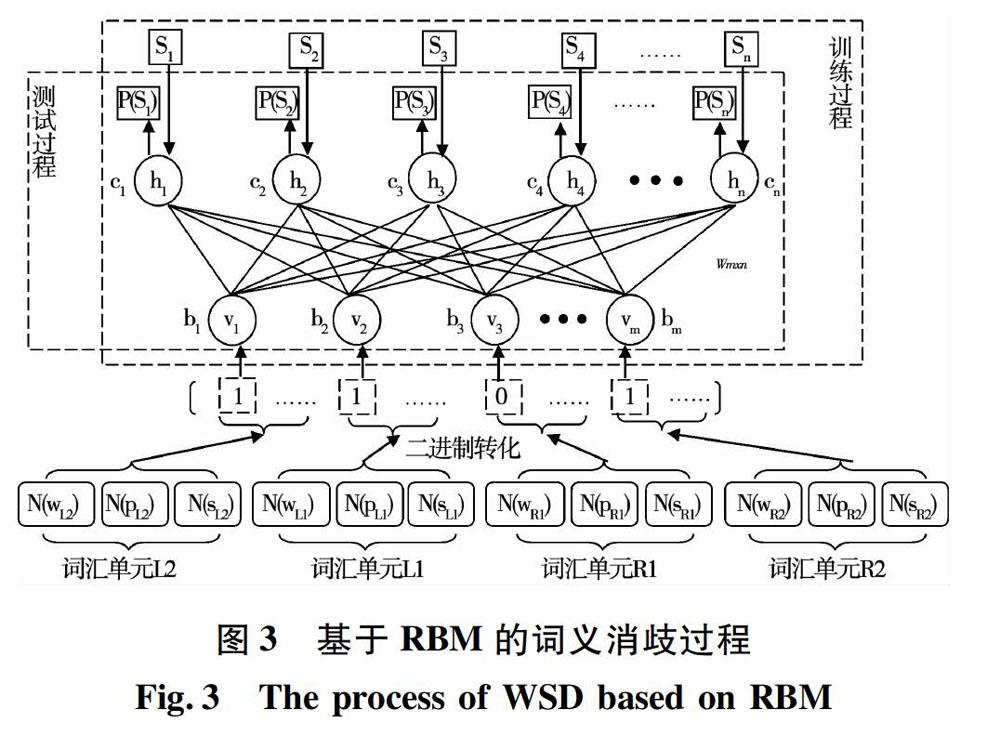
摘 要:针对汉语一词多义现象,根据上下文所蕴含的语言学知识,采用受限玻尔兹曼机(restricted boltzmann machine,RBM)来确定歧义词汇的真实含义。选取歧义词汇左右邻接的四个词单元中的词形、词性和语义类作为消歧特征。同时,使用RBM来构建词义消歧模型。结合SemEval-2007: Task#5的训练语料和哈尔滨工业大学的语义标注语料来优化RBM的参数。利用SemEval-2007: Task#5的测试语料对词义消歧模型进行测试。实验结果表明:相对于贝叶斯词义消歧分类器而言,受限玻尔兹曼机词义消歧方法的消歧准确率有所提高。
关键词:受限玻尔兹曼机;消歧特征;词义消歧;训练语料
DOI:10.15938/j.jhust.2019.05.019
中图分类号: TP391.2
文献标志码: A
文章编号: 1007-2683(2019)05-0116-06
Abstract:For polysemy phenomenon in Chinese, Restricted Boltzmann Machine (RBM) is adopted to determine the true meaning of ambiguous vocabulary where linguistic knowledge in context is used. Word form, part of speech and semantic categories in four left and right lexical units adjacent to an ambiguous word are selected as disambiguation features. At the same time, RBM is used to construct word sense disambiguation (WSD) model. Training corpus in SemEval-2007: Task#5 and semantic annotation corpus in Harbin Institute of Technology are used to optimize parameters of RBM. Test corpus in SemEval-2007: Task#5 is used to evaluate WSD model. Experimental results show that compared with Bayesian word sense disambiguation classifier, disambiguation accuracy of WSD method with RBM is improved.
0 引 言
词义消歧是计算语言学领域的关键性研究课题。近年来,随着文本数量的激增,自动判别词语的含义有着越来越广泛的需求。针对这一问题,国内外许多学者开展了大量的研究。
高雪霞[1]针对词义错误配对问题,提出了基于Jaccard系数的词义消歧算法,利用WordNet知识库中的知识源来表示歧义词的词义信息并生成词义资源库。同时,结合提出的基于Jaccard系数词义消歧算法来完成信息检索。杨陟卓[2]提出了一种基于上下文翻译的有监督词义消歧方法,将由译文所组成的上下文当作伪训练语料,并利用真实训练语料和伪训练语料共同确定歧义词的词义。陈浩[3]提出了一种基于语言模型的无指导词义消歧方法,在基于术语抽取的基础上,使用基于统计的语言模型来提高消歧性能。……