基于CUDA架构的LDPC码并行译码设计与实现
2018-06-19鲁邹晨
鲁邹晨
(中国电子科技集团公司第二十研究所,陕西 西安 710068)
0 引 言
信息在信道中传输时,难免受到噪声和衰落的干扰而出错。随着Shannon在信道编码定理[1]中证明采用信道编码技术能够在噪声干扰的环境中保持信息的高可靠传输,学者们陆续研究了多种有效的信道编码设计方法,其中包括了著名的Turbo码[2]和低密度奇偶校验码(LDPC)码。相较于Turbo码,LDPC码分组误码性能更优,译码算法简单。
随着半导体工艺的发展,高速计算研究理论逐渐兴起,在图形处理器(GPU)强大的并行运算架构下来实现算法加速具有的优越性使其成为可能。LDPC码的Scaled-MSA译码算法中,校验阵H各行(列)并行处理信息,符合采用全并行架构加速的特征。本文采用VS2010标准C编译器和CUDA6.0的集成开发环境,在GPU架构上实现了LDPC码的低时延、高吞吐量译码器,并与CPU译码以及不同线程数、并行度间的译码速度进行了比较。
1 系统开发环境
本文基于CUDA的集成开发环境研究并设计了高速率LDPC码编译码器,其中集成系统的开发环境需要以下支持:可以运行 CUDA平台的显卡和匹配驱动程序,CUDA工具包和C编译器。本文GPU采用GeForce 750Ti处理器,CPU采用Intel i3处理器,操作系统为WinXP。整个编译码系统采用CPU+GPU混合编译,GPU开发环境由NVIDIA公司开发的CUDA6.0提供;而CPU开发环境采用了VS2010中的标准C编译器。
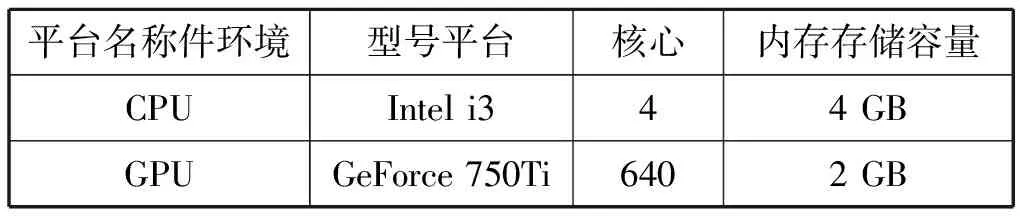
表1 CUDA架构的硬件环境
此款显卡的规格参数如表2所示,GPU并行计算加速比很大程度上依赖于流多处理器的数目和CUDA核心数。设备的显存决定了能存储的资源大小,各Block能够同时运行的最大线程数取决于图像处理器的硬件性能,在研究采用线程数对译码算法的加速能力时,调用线程数不能超过这个值。……