一种DOM树标签路径和行块密度结合的Web信息抽取方法
2017-09-18马晓慧李泓莹
智能计算机与应用 2017年4期
马晓慧++李泓莹
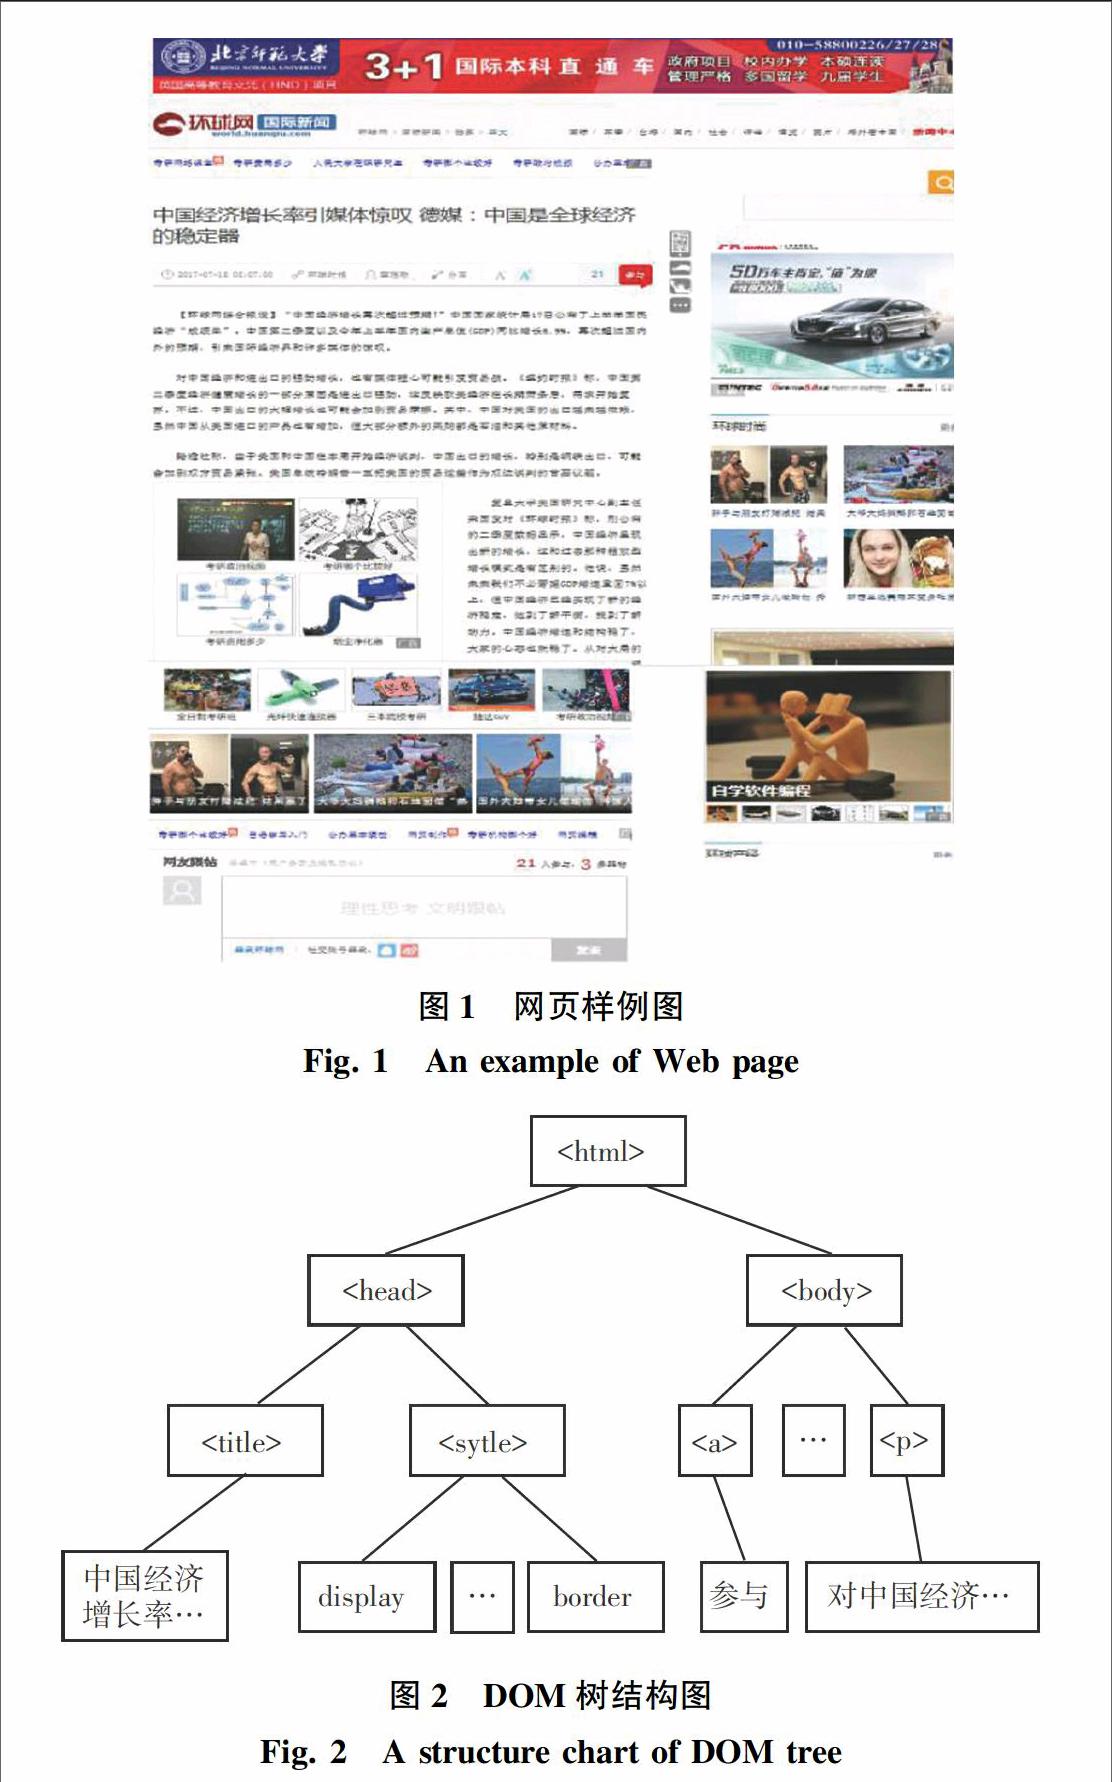
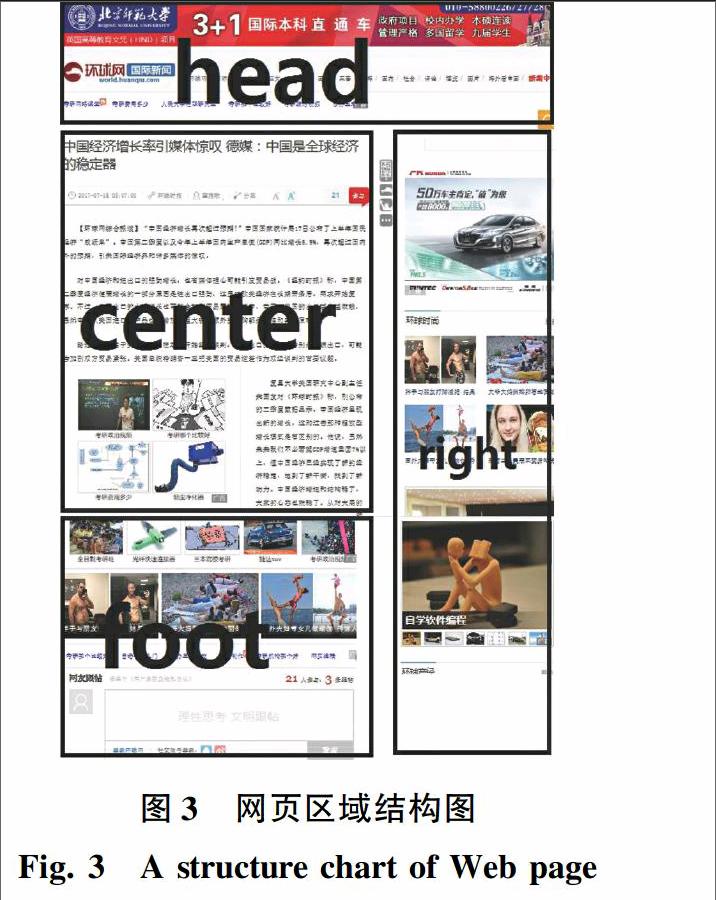
摘要:本文提出了一种标签路径和行块分布函数相结合的信息抽取方法来实现Web页面的信息抽取。该方法将Web页面解析成DOM树,使用视觉特征和标签过滤的规则将树进行剪枝,引入标签路径特征的方法粗略划分出网页的正文内容和噪音内容,最终使用行块分布函数的方法进行抽取,获得正文文本。实验结果表明,这种抽取方法有效地防止了正文内容误删及噪音内容漏删的现象,使得提取的正文信息更加准确,准确度达到91%,召回率达到95%,F值达到93%。本算法对于包含过多短文本的网页抽取的准确度还有待提高。
关键词: DOM树; 视觉特征; 标签路径特征; 行块分布函数
中图分类号:TP391
文献标志码:A
文章编号:2095-2163(2017)04-0013-05
0引言
Web页面是目前人们获取信息的主要方式之一,也是舆情监测、数据分析和处理的一个重要来源。常见的Web页面除了包含有用的正文信息外,还包含了大量的与正文主题无关的链接、图片、脚本等内容。因此,从纷杂的信息中快速准确地提取所需信息就显得尤为重要,Web页面的信息抽取也成为了研究的一个热点问题。
刘秉权[1]等提出了基于DOM树的方法,根据HTML标签把网页解析为一颗树,在树上通过DES算法、MDR算法等应用算法抽取网页中有效信息。聂卉[2]等深入研究了一种基于GATE语义标注的Web信息自动抽取技术,这种技术通过领域本体对网页进行语义标注准确定位目标项,再通过从构建好的DOM树中抽取语义项的特征描述构建样本实例,最后运用归纳算法实现抽取。……
登录APP查看全文
