排列熵算法参数的优化确定方法研究
2014-09-05饶国强冯辅周司爱威谢金良
振动与冲击 2014年1期
关键词:方法
饶国强, 冯辅周, 司爱威, 谢金良
(装甲兵工程学院 机械工程系, 北京 100072)
排列熵是衡量一维时间序列复杂度的平均熵参数,其计算简单、抗噪声能力强,是一种新的动力学突变检测方法,能够较好地反映时间序列数据的微小变化[1]。目前,排列熵算法在医学、环境等领域应用广泛[2-5],主要是对复杂系统进行异常检测,应用效果比较突出。
排列熵算法受自身参数的影响比较大,参数的选择仍然仅凭经验或直觉,从而使计算结果存在很大的不确定性。本文引入相空间重构方法,选择合适的排列熵算法参数确定方法,以期提高排列熵计算结果的准确性和算法效率。
1 排列熵算法
排列熵算法的基本原理如下:
设一时间序列{X(i),i=1,2,…,n},对其进行相空间重构,得到矩阵:
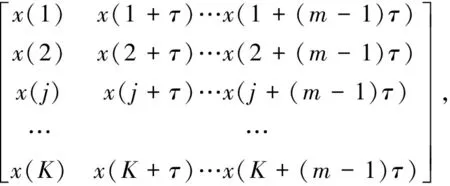
(1)
式中:m、τ分别为嵌入维数和延迟时间,K=n-(m-1)τ。矩阵中的每一行可看作一个重构分量,共有K个重构分量。然后对每个重构分量的元素,根据数值大小按照升序重新排列,提取各个元素在原重构分量中所在列的索引,可以得到不同的符号序列,m维相空间映射不同的符号序列总共有m!。若k种不同符号序列出现的概率为P1,P2,…,Pk,则按照Shannon熵的形式,排列熵可以定义为:
(2)
将HPE(m)进行归一化处理,即:
0≤HPE=HPE/ln(m!)≤1
(3)
根据排列熵算法的基本原理,相空间重构是模型的第一步,其延迟时间τ和嵌入维数m是排列熵算法的主要参数,对于排列熵的计算结果有较大的影响。
2 相空间重构
相空间重构方法是由Takens在1981年提出,其基本思想是:系统中任一分量的……
登录APP查看全文