改进的RBF文本分类算法
2011-08-04王欣欣赖惠成
通信技术 2011年12期
王欣欣,赖惠成
(新疆大学 信息科学与工程学院,新疆 乌鲁木齐 830046)
0 引言
目前国内外基于内容信息过滤的研究主要集中在核心算法上,基本上可以概括用户模板的构建及其算法研究和用户模板与文本的匹配技术两个方面,这两个方面是文本信息过滤的两大关键技术。
很多分类技术应用到文本分类中,取得了良好的效果,包括神经网络、支持向量机[1]以及决策树方法等,而其中利用神经网络方法的文本分类,关键是提取出既能比较全面地反映文档类别的信息,又有利于神经网络学习的特征;其次对应着选取的特征,需要设计合适的网络结构来分类,因此提出一种基于互信息的特征提取[1],结合聚类算法的思想,采用基于样本中心的 RBF分类算法进行分类实验,并给出仿真结果。
1 文本分类系统
简单地说,文本分类系统的任务是:在给定的分类体系下,根据文本的内容自动地确定与文本关联的类别。自动文本分类即根据统计模式识别思想,将文本表示成特征向量,然后用训练文本对事先选定的分类器进行训练,直接或间接地提取出蕴涵在训练文本中有关各个文本类的统计特性,并根据这些特性确定出分类准则,最后依据这些准则对未知文本进行分类决策。一个典型的文本分类系统如图1所示。
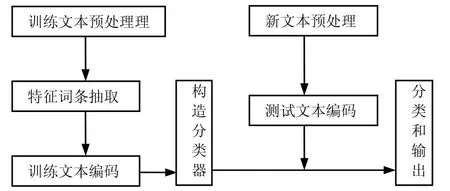
图1 文本分类系统
2 聚类算法
典型的聚类过程主要包括数据(或称之为样本或模式)准备、特征选择和特征提取、接近度计算、聚类或分组、对聚类结果进行有效性评估等步骤[3]。……
登录APP查看全文